L'analyse documentaire par IA automatise l'extraction, la structuration et la recherche d'informations dans des contrats, factures ou rapports, quel que soit leur format d'origine. Pour un usage professionnel sérieux, la meilleure approche combine un modèle multimodal capable de lire tableaux et annotations manuscrites, un pipeline de validation humaine, et une gouvernance des données vérifiable. Trois critères priment avant tout déploiement : la précision réelle sur documents hétérogènes, la sécurité de l'hébergement, et la facilité d'intégration avec vos systèmes existants.
En bref:
- Les modèles de langage multimodaux permettent une compréhension contextuelle plus précise que l'OCR pour traiter des documents hétérogènes, y compris manuscrits et tableaux imbriqués.
- La réussite d'un déploiement repose sur une démarche intégrée comprenant la capture, l'extraction, la structuration, la validation humaine et l'intégration des données.
- La conformité à la nLPD exige une gouvernance rigoureuse, notamment en matière de sécurité, d'audit, et de gestion des données sensibles ou personnelles.
- Une plateforme hébergée exclusivement en Suisse, comme Nectos, garantit la souveraineté des données, une conformité renforcée et une transparence totale dans le traitement documentaire.
- La tendance future va vers une compréhension encore plus fine des relations visuelles et sémantiques dans les documents, avec un focus accru sur la souveraineté et la sécurité.
Table des matières
- Quelles technologies rendent l'analyse documentaire par IA possible ?
- Comment construire un pipeline d'analyse documentaire fiable ?
- Quels cas d'usage concrets justifient l'investissement ?
- Quelles questions poser avant de choisir une solution ?
- Comment gérer les risques et rester conforme à la nLPD ?
- Ce que Nectos apporte aux organisations suisses
- Quelles architectures rendent tout cela possible en pratique ?
- Faut-il choisir une solution open source ou propriétaire ?
- Quel est l'impact réel de la confidentialité sur le traitement documentaire ?
- Quelles ressources matérielles pour un traitement en temps réel ?
- Comment personnaliser et entraîner un modèle pour vos documents ?
- Vers où va l'analyse documentaire par IA ?
- Nectos, la solution souveraine pour vos documents sensibles
- Pour aller plus loin
- Sources
- Questions fréquentes
Quelles technologies rendent l'analyse documentaire par IA possible ?
Pendant longtemps, la reconnaissance de caractères (OCR) a suffi à transformer une image de texte en chaîne de caractères exploitable. Elle reste utile, mais elle atteint vite ses limites face à un tableau financier scanné de travers, une signature manuscrite ou un formulaire dont la mise en page change d'une agence à l'autre.
Les modèles de langage multimodaux changent la donne différemment de ce qu'on croit généralement : ils ne se contentent pas de mieux lire, ils comprennent le contexte. Un LLM multimodal identifie qu'une colonne de chiffres est un montant de TVA parce qu'il reconnaît la structure du document, pas seulement les caractères qui la composent. Cette compréhension sémantique et contextuelle des documents hétérogènes permet de traiter des manuscrits, des photos de mauvaise qualité ou des tableaux imbriqués sans règle métier écrite à la main pour chaque cas.
Au delà du modèle lui-même, les plateformes d'analyse documentaire s'appuient sur des briques logicielles spécialisées, parfois appelées « processors » :
- Le classifieur (custom classifier) trie automatiquement les documents entrants par type : facture, contrat, relevé bancaire, avant même de lancer l'extraction.
- Le séparateur (custom splitter) découpe un fichier PDF contenant plusieurs documents distincts, un lot de factures scannées ensemble par exemple, en unités traitables séparément.
- L'extracteur personnalisé (custom extractor) repère les champs qui vous intéressent réellement (numéro de contrat, date d'échéance, montant net) et les convertit en données typées.
Google Cloud illustre bien ce fonctionnement modulaire avec sa solution Document AI, qui propose ces trois types de processors accessibles via API, à titre d'exemple fonctionnel plutôt que de recommandation. Le principe mérite d'être compris même si vous choisissez une autre plateforme, car il structure la manière dont presque tous les outils sérieux du marché organisent leur traitement documentaire.
Le format de sortie déterminé la valeur pratique de tout cela. Un texte brut extrait d'un PDF ne sert à rien s'il faut le retraiter à la main. Les systèmes matures exportent des champs typés en JSON ou CSV, prêts à être injectés dans un ERP, un CRM ou une base de données de recherche. C'est cette structuration finale, plus que la reconnaissance de texte en elle même, qui détermine si vous gagnez réellement du temps.
Comment construire un pipeline d'analyse documentaire fiable ?
Un déploiement réussi suit toujours la même logique, même si chaque organisation l'adapte à ses contraintes. La numérisation IA correctement intégrée réduit les délais de traitement documentaire et améliore la qualité des données, mais uniquement quand ces cinq étapes sont pensées ensemble plutôt qu'implémentées séparément.
- Capture : les documents arrivent par scan, e-mail, extension de navigateur ou import direct. Certaines plateformes permettent de capter des pages web protégées ou des documents issus de portails tiers via une extension dédiée, ce qui simplifie la constitution d'un corpus de test.
- Extraction : le modèle lit le contenu brut, texte, tableaux, cases cochées, et produit une première version des données.
- Structuration : les données extraites sont typées, normalisées (formats de date, devises) et rangées selon un schéma défini à l'avance.
- Validation humaine : un relecteur corrige les cas ambigus, particulièrement sur les documents mal scannés ou aux formats locaux inhabituels.
- Intégration : les données validées partent vers votre système cible via API, avec conservation de l'original et de la trace des corrections pour audit ultérieur.
Le choix entre traitement par lot (batch) et traitement en flux continu (streaming) dépend surtout de votre volume et de votre tolérance à la latence. Un cabinet d'avocats qui traite cinquante contrats par semaine n'a aucune raison de viser le temps réel ; une plateforme de facturation qui reçoit des documents en continu, si.
Pour un projet pilote, la durée habituelle se situe souvent dans un délai de plusieurs semaines, variable selon la diversité des formats documents et la complexité du déploiement. La durée varie surtout selon la diversité des formats à couvrir : plus vos documents sont hétérogènes, plus il faut de cycles d'ajustement. Un point souvent sous estimé, mais qui domine l'effort réel de mise en production : ce sont les cas rares, documents mal scannés, champs manuscrits, formats régionaux inhabituels, qui déterminent si votre pipeline tient la route, bien plus que la précision moyenne sur les cas simples.
Conseil de pro : ne mesurez jamais un POC uniquement sur sa précision globale. Isolez un échantillon volontairement « sale » (photos floues, formulaires manuscrits, PDF mal orientés) et suivez son taux d'erreur séparément. C'est ce sous ensemble qui révèle si l'outil tiendra en production.
Trois indicateurs méritent un suivi permanent une fois le système en place : le taux de validation humaine nécessaire (idéalement décroissant avec le temps), le délai moyen de traitement par document, et le taux d'erreur détecté après intégration dans le système cible.
Quels cas d'usage concrets justifient l'investissement ?
Le juridique reste l'un des terrains les plus rentables pour l'analyse documentaire par IA. La revue contractuelle, qui consiste à repérer des clauses de résiliation, des durées d'engagement ou des pénalités dans des centaines de pages, se prête particulièrement bien à l'extraction automatisée. La due diligence lors d'une fusion acquisition suit la même logique : croiser rapidement des dizaines de contrats pour identifier les clauses à risque.
Dans la finance, l'extraction de données pour les rapports réglementaires (bilans, relevés, justificatifs de dépenses) automatise une tâche répétitive à faible valeur ajoutée pour les équipes comptables. Un guide pratique sur la numérisation de reçus et de notes de frais illustre bien ce type d'usage courant, où le gain vient moins de la sophistication du modèle que de la constance du processus.
La recherche académique et la veille documentaire bénéficient d'un usage différent : la recherche sémantique permet de retrouver un passage précis dans un corpus de milliers de publications sans connaître les mots-clés exacts utilisés par l'auteur.
Certains points de vigilance reviennent dans presque tous les secteurs :
- Les documents contenant des données personnelles sensibles (dossiers médicaux, informations RH) exigent un contrôle strict de qui a accès à quoi, et une trace de chaque consultation.
- Les formats non standards, contrats rédigés à la main, tableaux imbriqués dans des rapports PDF anciens, restent la principale source d'erreur, quel que soit l'outil choisi.
- Les gains mesurables varient énormément selon la maturité documentaire de départ : une entreprise qui numérise déjà proprement gagnera moins en proportion qu'une équipe partant de dossiers papier.
Aucun outil, même performant, n'élimine complètement le besoin de relecture sur les documents à fort enjeu juridique ou financier. C'est une limite réaliste à intégrer dès le cahier des charges plutôt qu'une déception à découvrir en production.
Quelles questions poser avant de choisir une solution ?
Comparer des outils d'analyse documentaire par IA sur la seule base d'une démonstration commerciale mène souvent à de mauvaises surprises. Certains critères se vérifient uniquement en creusant au delà de la présentation produit.
Sur le plan technique, vérifiez la robustesse face à des documents hétérogènes réels, et pas seulement les exemples propres fournis en démo. Un article expliquant comment fonctionne l'analyse de données avec l'intelligence artificielle rappelle que la performance annoncée sur un jeu de test standardisé ne prédit pas toujours la performance sur vos propres documents, souvent bien plus désordonnés.
Voici les questions à poser systématiquement à un fournisseur :
- Où sont physiquement hébergées les données pendant et après le traitement ?
- Les journaux d'accès sont-ils exportables pour un audit interne ou une autorité de contrôle ?
- Les documents envoyés servent-ils à ré entraîner le modèle du fournisseur, et peut-on désactiver cette option contractuellement ?
- Quel est le format d'export exact des données structurées (JSON, CSV, champs typés personnalisables) ?
- Quel niveau de service (SLA) est garanti en cas d'indisponibilité, et sur quelle durée les données sont-elles conservées ?
- Le tarif est-il basé sur le volume de pages, le nombre d'utilisateurs, ou un forfait fixe ?
La pondération de ces critères change radicalement selon votre contrainte principale. Une étude notariale ou un cabinet d'avocats suisse, soumis à des obligations de secret professionnel strictes, doit placer la souveraineté des données et la traçabilité au sommet, quitte à accepter un déploiement plus lent. Une start up qui traite des documents publics sans donnée sensible peut légitimement prioriser la rapidité de mise en œuvre et le coût.
Conseil de pro : demandez toujours un export d'exemple avant signature, pas seulement une capture d'écran. Un JSON mal structuré ou des champs mal typés révèlent en quelques minutes des problèmes d'intégration qui coûteraient des semaines à corriger après le déploiement.
Un guide pratique sur la classification documentaire par IA et les étapes de déploiement détaille utilement comment structurer cette phase de test avant tout engagement contractuel de long terme.
Comment gérer les risques et rester conforme à la nLPD ?
Aucun système d'analyse documentaire par IA n'est exempt de risques, et les ignorer coûte généralement plus cher que de les anticiper. Trois catégories de risques reviennent systématiquement.
Le biais d'extraction survient quand un modèle a été entraîné majoritairement sur un type de document et se comporte de façon imprévisible face à un format inhabituel, un contrat rédigé dans une langue régionale, par exemple. La fuite de données reste le risque le plus redouté : un document confidentiel qui transite par un serveur situé hors de Suisse, potentiellement soumis à une législation étrangère d'accès aux données, échappe au contrôle de l'organisation qui l'a envoyé. Enfin, la décision automatisée sans supervision, refuser un dossier de crédit sur la seule base d'une extraction automatique, pose un problème à la fois éthique et juridique.
Des mesures concrètes limitent ces risques :
- L'anonymisation des données sensibles avant tout traitement, quand la nature du document le permet.
- Les journaux d'audit complets, qui tracent qui a consulté quel document et quand, indispensables en cas de contrôle.
- La validation humaine systématique sur les décisions à fort impact, plutôt qu'une automatisation totale.
- Des tests d'équité réguliers sur des échantillons de documents variés, pour détecter un biais avant qu'il ne cause un dommage réel.
En Suisse, la nLPD impose des obligations de transparence, de proportionnalité et de journalisation pour tout traitement de données par IA, et exige une analyse d'impact relative à la protection des données pour les traitements jugés à risque élevé. Concrètement, cela signifie qu'une organisation suisse ne peut pas se contenter de vérifier la performance technique d'un outil : elle doit documenter où vont les données, pourquoi elles y vont, et combien de temps elles y restent. Intégrer ces exigences dès la phase contractuelle, plutôt qu'après un incident, évite des semaines de mise en conformité rétroactive.
Ce que Nectos apporte aux organisations suisses
Face à ces enjeux de gouvernance, une plateforme d'analyse documentaire qui héberge ses données exclusivement sur des serveurs suisses répond directement aux exigences de la nLPD plutôt que de les traiter comme une contrainte annexe. Nectos a construit son offre autour de ce principe : chaque document traité reste en Suisse, sans transfert vers des infrastructures soumises à d'autres juridictions.
Plusieurs éléments vérifiables soutiennent cette approche :
- Hébergement exclusivement sur des serveurs situés en Suisse, sans dépendance à des géants technologiques américains.
- Anonymisation automatique des invites (prompts) avant traitement, pour limiter l'exposition des données sensibles.
- Journaux d'audit complets et exportables, utiles en cas de contrôle de conformité ou d'analyse d'impact requise par la nLPD.
- Gestion de rôles et contrôle d'accès administrateur, pour restreindre qui consulte quel document au sein d'une organisation.
Cette architecture répond typiquement aux besoins des cabinets d'avocats, sociétés fiduciaires, équipes RH ou institutions de santé qui doivent conjuguer analyse documentaire performante et obligations de secret professionnel. La page consacrée à la sécurité de Nectos détaille les garanties techniques associées, pendant que celle sur l'engagement écoresponsable présente le choix d'une infrastructure alimentée en énergie renouvelable, un critère de plus en plus regardé par les organisations soucieuses de leur impact global.
Quelles architectures rendent tout cela possible en pratique ?
Sous le capot, la plupart des systèmes d'analyse documentaire par IA reposent sur une architecture en couches. Une couche de prétraitement normalise les formats d'entrée (PDF, image, scan) avant de les transmettre à un modèle multimodal chargé de l'extraction sémantique. Une couche de post-traitement applique ensuite des règles de validation et de typage avant d'écrire les résultats dans un référentiel indexable.
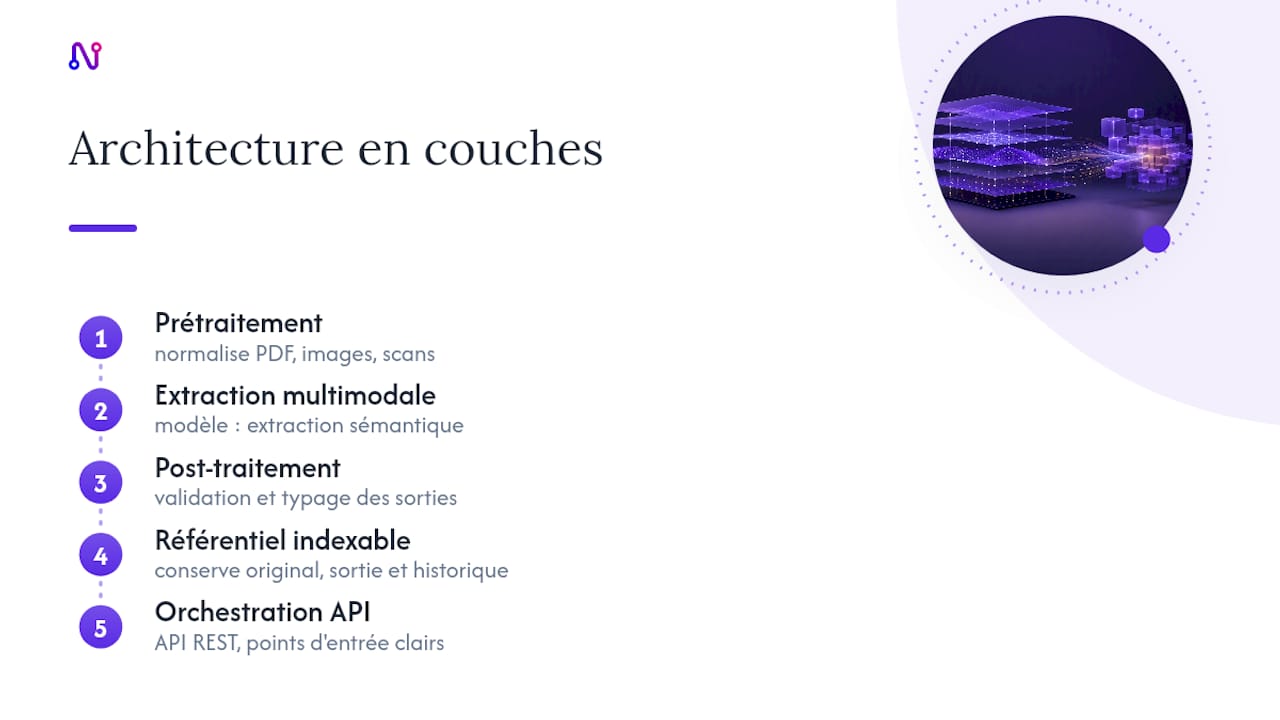
Ce référentiel joue un rôle souvent sous estimé : conserver l'original, la sortie structurée et l'historique des corrections humaines permet non seulement l'audit, mais aussi la recherche sémantique ultérieure dans l'ensemble du corpus traité. Sans cette mémoire structurée, chaque nouveau document repart de zéro, sans bénéficier de l'apprentissage accumulé sur les cas similaires déjà corrigés.
L'orchestration entre ces couches se fait généralement via des API REST, ce qui explique pourquoi la qualité de la documentation technique d'un fournisseur compte presque autant que la qualité du modèle lui même. Une architecture bien pensée expose des points d'entrée clairs pour chaque étape (classification, extraction, validation), ce qui facilite le remplacement d'un composant sans reconstruire tout le pipeline. C'est un critère technique à vérifier avant tout engagement, particulièrement si vous prévoyez de faire évoluer vos besoins dans les prochaines années.
Faut-il choisir une solution open source ou propriétaire ?
Le choix entre outils open source et solutions propriétaires dépend moins de la performance brute que de vos contraintes de gouvernance et de vos ressources internes. Les modèles open source offrent un contrôle total sur l'hébergement, y compris un déploiement entièrement local, ce qui séduit les organisations aux exigences de confidentialité maximales. Mais ce contrôle a un coût : il faut une équipe technique capable de maintenir, entraîner et sécuriser l'infrastructure dans la durée.
Les solutions propriétaires proposent en général une intégration plus rapide, une documentation plus complète et un support commercial, au prix d'une dépendance à l'infrastructure du fournisseur. La question de la localisation des données devient alors centrale : certains grands fournisseurs cloud, notamment américains, restent soumis à des législations d'accès aux données qui peuvent entrer en conflit avec les obligations de confidentialité suisses.
Une troisième voie existe, souvent négligée dans les comparatifs : des plateformes propriétaires mais hébergées exclusivement sur un territoire donné, qui combinent la simplicité d'usage d'une solution commerciale avec la maîtrise juridique d'un hébergement local. Pour une organisation suisse manipulant des données sensibles, ce compromis évite à la fois la charge de maintenance de l'open source auto hébergé et les risques juridiques d'un hébergement à l'étranger.
Quel est l'impact réel de la confidentialité sur le traitement documentaire ?
Chaque document envoyé à un système d'analyse par IA pose une question simple mais rarement posée clairement : que devient-il après traitement ? Sert-il à améliorer le modèle du fournisseur ? Est-il conservé, et où ?
Pour les organisations suisses, la nLPD encadre strictement ces questions, avec des obligations de finalité et de proportionnalité qui s'appliquent dès qu'une donnée personnelle transite par un système automatisé. Un cabinet médical ou juridique ne peut pas se contenter de vérifier que l'outil « fonctionne bien » : il doit pouvoir démontrer, en cas de contrôle, que les données ont été traitées dans le cadre défini et pour la durée prévue.
Concrètement, cela pousse à privilégier des solutions qui séparent nettement le traitement du document de son utilisation pour l'entraînement futur d'un modèle, et qui permettent de désactiver contractuellement cette réutilisation. L'anonymisation en amont, quand la nature du document le permet, réduit également l'exposition en cas d'incident. La confidentialité n'est donc pas un frein à l'automatisation documentaire, mais un paramètre de conception à intégrer dès le choix de l'outil plutôt qu'à corriger après coup.
Quelles ressources matérielles pour un traitement en temps réel ?
La question des ressources matérielles dépend presque entièrement de l'endroit où tourne le modèle. Une solution qui s'appuie sur une API cloud externe déporte cette charge chez le fournisseur : votre organisation n'a besoin que d'une connexion réseau stable et d'une intégration applicative légère.
À l'inverse, un déploiement local ou souverain, où le modèle tourne sur une infrastructure que vous contrôlez, exige des ressources de calcul substantielles, en particulier pour des modèles multimodaux volumineux. Le compromis se joue alors entre latence, coût d'infrastructure et souveraineté des données. Pour un traitement en temps réel sur de gros volumes, la parallélisation du traitement par lots devient rapidement nécessaire pour éviter les goulots d'étranglement, surtout quand plusieurs types de documents (factures, contrats, formulaires) transitent simultanément dans le même pipeline. Les organisations qui n'ont pas besoin d'un traitement instantané gagnent souvent à privilégier un traitement par lot planifié la nuit, ce qui réduit la pression sur l'infrastructure et les coûts associés.
Comment personnaliser et entraîner un modèle pour vos documents ?
La personnalisation d'un système d'analyse documentaire ne demande presque jamais de reconstruire un modèle depuis zéro. La plupart des plateformes sérieuses permettent d'affiner un extracteur personnalisé à partir d'un nombre limité de documents étiquetés, souvent entre dix et cinquante exemples représentatifs suffisent pour améliorer nettement la précision sur un type de document spécifique.
La qualité de ces exemples compte plus que leur quantité. Il vaut mieux dix documents couvrant les cas difficiles réels (mauvaise qualité de scan, mise en page inhabituelle) que cinquante documents parfaitement propres qui ne représentent pas la diversité rencontrée en production. Réévaluer régulièrement le modèle sur de nouveaux échantillons, plutôt qu'une fois au lancement puis plus jamais, permet de détecter une dérive de performance avant qu'elle n'affecte la production à grande échelle.
Vers où va l'analyse documentaire par IA ?
La tendance de fond va vers une multimodalité plus fine : comprendre non seulement le texte et les tableaux, mais les relations visuelles entre éléments d'une page, signature, tampon, mise en évidence manuscrite. En parallèle, la demande pour des déploiements souverains ou sur infrastructure dédiée progresse, portée par des obligations réglementaires de plus en plus strictes en Europe et en Suisse.
Sur le plan organisationnel, cela déplace les compétences recherchées : moins d'ingénieurs spécialisés en reconnaissance de caractères, davantage de profils capables d'évaluer la qualité d'un pipeline et de dialoguer avec la conformité. Notre recommandation reste constante : commencez par un POC modulaire sur un périmètre restreint, mesurez la performance sur les cas difficiles plutôt que sur la moyenne, et construisez la gouvernance dès le premier déploiement plutôt qu'en réaction à un incident.
— Adopt
Nectos, la solution souveraine pour vos documents sensibles
Contrairement aux plateformes qui font transiter vos documents par des serveurs situés hors de Suisse, Nectos garde chaque contrat, chaque dossier client, chaque rapport financier sur une infrastructure exclusivement suisse.

Concrètement, cela veut dire que vos équipes juridiques, comptables ou RH peuvent analyser des documents sensibles sans se demander où finissent réellement les données. L'anonymisation automatique des invites, les journaux d'audit exportables et la gestion fine des rôles d'accès donnent à votre organisation des preuves de conformité qu'exige la nLPD. Cette approche s'accompagne d'un choix d'infrastructure alimentée en énergie renouvelable, un critère qui compte de plus en plus dans les appels d'offres publics et privés.
Si votre organisation manipule des documents confidentiels au quotidien, la meilleure façon de juger si Nectos correspond à vos besoins reste de tester la plateforme sur vos propres cas d'usage. Consultez la page sécurité de Nectos pour évaluer les garanties techniques, puis lancez un essai sur un échantillon réel de vos documents.
Pour aller plus loin
Pour approfondir la mise en œuvre technique, la documentation de Document AI sur Google Cloud détaille le fonctionnement des processors personnalisés à titre d'exemple fonctionnel. Le guide sur la classification documentaire et le déploiement par étapes donne une feuille de route concrète pour structurer un POC. Sur le volet réglementaire suisse, l'article consacré à la conformité nLPD des PME face à l'IA reste la référence la plus à jour pour comprendre les obligations de journalisation et d'analyse d'impact. Enfin, l'analyse de LlamaIndex sur les LLM multimodaux éclaire utilement la différence technique entre OCR classique et compréhension contextuelle des documents.
Sources
- AI document parsing: LLMs are redefining how machines read and understand documents — LlamaIndex
- Document AI — Google Cloud
- Numérisation IA : Booster la Gestion Documentaire — Edana
Questions fréquentes
Comment faire analyser un document par une IA ?
Il suffit généralement d'importer le fichier (PDF, image, scan) dans une plateforme d'analyse documentaire, qui applique un modèle multimodal pour extraire le texte, les tableaux et les champs clés, puis structure ces données dans un format exploitable comme le JSON.
ChatGPT peut-il analyser un document ?
Certains assistants conversationnels généralistes permettent de lire un document et d'en résumer le contenu, mais ils ne proposent généralement pas les processors spécialisés (extracteur, classifieur) ni les garanties de gouvernance nécessaires pour un usage professionnel sensible. Pour ce cas, une plateforme dédiée avec traçabilité complète comme Nectos reste plus adaptée aux organisations soumises à la nLPD.
Quelle IA est la plus adaptée pour analyser des documents ?
Le meilleur choix dépend de votre priorité : les solutions cloud génériques comme Document AI offrent des processors puissants pour l'extraction à grande échelle, tandis qu'une plateforme souveraine comme Nectos convient mieux aux organisations suisses qui doivent garantir l'hébergement local et la conformité nLPD.
Document AI de Google est-il gratuit ?
Document AI propose un niveau d'essai gratuit avec des quotas limités de pages traitées par mois, mais l'usage en production à volume significatif est facturé selon le nombre de pages et les processors utilisés.