L'IA sur documents transforme des fichiers non structurés (contrats, factures, formulaires) en données structurées prêtes pour vos systèmes en aval : extraction automatique, classification et résumé exploitable. Le gain de productivité est immédiat, mais aucun pipeline sérieux ne se passe d'une validation humaine sur les cas à faible confiance.
En bref:
- L'IA documentaire va au-delà de l'OCR classique en comprenant et structurant le contenu des documents pour automatiser leur traitement, tout en nécessitant une validation humaine pour les résultats à faible confiance.
- Elle offre des capacités concrètes telles que l'extraction de champs, la classification automatique et le résumé de documents, indispensables dans des secteurs comme la finance, la santé ou le droit.
- La fiabilité d’un pipeline d’IA documentaire dépend largement de la qualité du prétraitement, de la précision des modèles d’extraction et d’un système de validation avec scores de confiance calibrés.
- Un déploiement réussi requiert de commencer par un cas pilote précis, d’analyser les indicateurs de performance, et de surveiller en continu la précision tout en préparant un plan de repli.
- La souveraineté des données impose d’opter pour une plateforme hébergée en Suisse, garantissant la traçabilité, l’auditabilité et le contrôle juridique sur le traitement des documents.
Table des matières
- Qu'est-ce que l'IA documentaire, et en quoi diffère-t-elle de l'OCR classique ?
- Quelles capacités concrètes offre l'IA appliquée aux documents ?
- Comment fonctionne un pipeline de traitement documentaire par IA ?
- Comment déployer un projet d'IA documentaire, du pilote à la production ?
- Quelle architecture choisir pour héberger l'IA documentaire ?
- Comment sécuriser et gouverner les documents traités par IA ?
- Quelles sont les limites de l'IA documentaire, et comment les valider ?
- Pourquoi la preuve technique compte plus que la promesse marketing
- Une plateforme d'IA documentaire qui reste sous juridiction suisse
- Sources
- Questions fréquentes
Qu'est-ce que l'IA documentaire, et en quoi diffère-t-elle de l'OCR classique ?
L'OCR classique lit du texte. L'IA documentaire, elle, le comprend. Cette distinction change tout pour un professionnel qui doit automatiser le traitement de documents numériques plutôt que simplement les numériser.
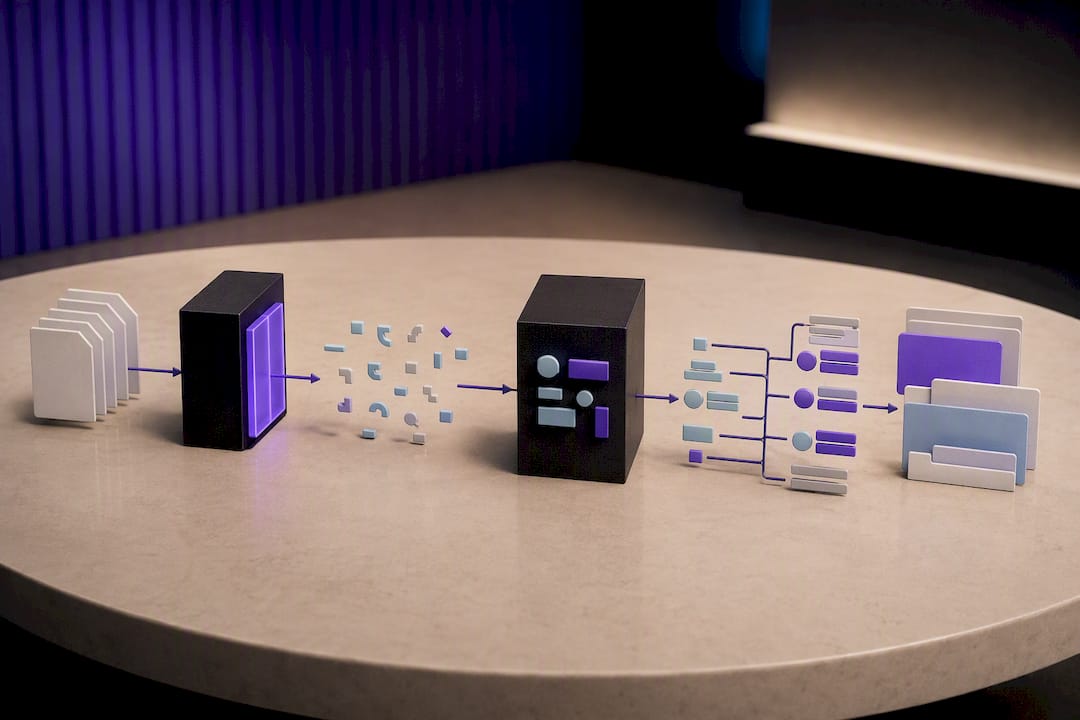
Un scanner OCR traditionnel transforme une image de facture en chaîne de caractères brute, sans distinguer le numéro de commande du montant total. L'IA documentaire combine l'OCR, l'apprentissage automatique et le traitement du langage naturel pour reproduire le raisonnement d'un employé qui lirait le document : elle identifie les champs, comprend leur contexte et structure le résultat en données exploitables, comme le détaille IBM dans sa présentation technique du domaine. Databricks va plus loin en soulignant que cette IA transforme des documents non structurés (contrats, formulaires, factures) en données directement injectables dans un flux d'automatisation ou un tableau de bord métier, selon son analyse du sujet.
Quelques termes reviennent systématiquement dans ce domaine, et mieux vaut les maîtriser avant de lancer un projet :
- Extraction de champs : isoler une donnée précise (date, montant, nom) dans un document et l'associer à une étiquette structurée.
- Splitting (séparation de documents) : détecter automatiquement où un document se termine et où le suivant commence dans un lot scanné en vrac.
- Classifier : le modèle qui range chaque document dans une catégorie (facture, contrat, relevé) avant tout traitement.
- Score de confiance : la probabilité, exprimée par le modèle, que son extraction soit correcte, base de tout arbitrage entre automatisation et relecture humaine.
Retenez ceci : l'OCR répond à « que dit ce texte ? », l'IA documentaire répond à « que signifie ce document, et que dois je en faire ? ».
Quelles capacités concrètes offre l'IA appliquée aux documents ?
Chaque fonctionnalité de l'IA documentaire répond à un besoin métier précis, et leur valeur dépend largement du cas d'usage visé.
- OCR amélioré et analyse de mise en page : au delà de la reconnaissance de caractères, le modèle interprète la structure visuelle du document (colonnes, tableaux, en-têtes) pour préserver le sens de la mise en forme originale. Un relevé bancaire scanné de travers reste lisible dès lors que le moteur reconnaît les zones logiques du document.
- Extraction de champs structurés et de tableaux : c'est la fonction la plus demandée en comptabilité et en assurance. Extraire automatiquement un numéro de police, une date d'échéance ou les lignes d'un tableau de facturation évite la ressaisie manuelle, source classique d'erreurs.
- Classification, séparation et routage automatique : un lot de 200 pages scannées contenant factures, bons de livraison et réclamations peut être trié et redirigé vers le bon service sans intervention humaine préalable. C'est souvent le premier maillon d'un pipeline de traitement documentaire.
- Résumé, questions réponses et recherche sémantique : avec l'arrivée de l'IA générative, on ne se contente plus d'extraire des champs, on interroge le document en langage naturel. Un juriste peut demander « quelles clauses limitent la responsabilité dans ce contrat ? » et obtenir une réponse directement issue du texte.
L'apport de l'IA générative sur ce dernier point mérite une nuance : elle rend l'extraction plus flexible face à des documents à formats variables, mais elle augmente aussi le besoin de vérification, car un résumé mal calibré peut sembler convaincant tout en étant inexact.
En finance et en assurance, ces capacités s'appliquent au traitement des factures et des sinistres. En santé, à la structuration des comptes rendus médicaux. En droit, à l'analyse de contrats volumineux. Dans chaque secteur, le point commun reste le même : transformer un flux de documents hétérogènes en données fiables et interrogeables.
Comment fonctionne un pipeline de traitement documentaire par IA ?
Un pipeline de Document AI suit rarement une ligne droite. Il s'agit d'un enchaînement de quatre grandes étapes, chacune avec ses propres points de défaillance possibles.
Le prétraitement ouvre la marche : normalisation des formats (PDF, images, scans), redressement des pages inclinées, et OCR par lots sur l'ensemble du corpus. Un document mal orienté ou compressé avec une qualité trop faible peut faire chuter la précision de toutes les étapes suivantes, quelle que soit la sophistication du modèle utilisé ensuite.
Vient ensuite la reconnaissance de structure et l'extraction, qui combine analyse de mise en page, reconnaissance d'entités nommées (NER) et modèles d'extraction, parfois complétés par des règles métier explicites pour les cas ambigus. C'est ici que le système distingue un montant total d'un sous-total, ou une date d'émission d'une date d'échéance.
La troisième étape mobilise les modèles génératifs pour le résumé et les questions réponses, une couche devenue courante depuis l'essor des grands modèles de langage. Elle permet d'interroger un document librement plutôt que de se limiter à des champs prédéfinis.
Enfin, le scoring et la validation ferment la boucle : chaque extraction reçoit un score de confiance, et les résultats sous un seuil défini sont automatiquement redirigés vers une relecture humaine. H2O.ai insiste sur ce point : la précision globale d'un système de Document AI dépend directement de la robustesse de ce pipeline et de la qualité de la boucle de validation, pas seulement du modèle utilisé.
Les points de vigilance techniques à ne pas négliger :
- Journaliser chaque extraction avec son score de confiance, pour permettre un audit ultérieur.
- Prévoir un chemin de validation humaine explicite, pas seulement un score affiché sans action associée.
- Tester le pipeline sur des documents réels dégradés (scans de mauvaise qualité, photos de smartphone), pas uniquement sur des PDF natifs propres.
- Séparer clairement les logs techniques des données personnelles extraites, pour simplifier la conformité.
Conseil de pro : Ne lancez jamais un pipeline en production sans avoir mesuré son taux d'erreur sur un échantillon représentatif de vos pires documents, ceux qui sont scannés de travers, tachés ou photographiés à la va-vite. C'est là, et non sur vos PDF les plus propres, que se révèle la vraie robustesse du système.
Comment déployer un projet d'IA documentaire, du pilote à la production ?
Un projet de Document AI réussi suit une progression méthodique, rarement un déploiement massif d'un coup.
- Choisissez un cas pilote circonscrit et mesurable. Un seul type de document (les factures fournisseurs, par exemple) et un objectif chiffré clair : réduction du temps de traitement, taux d'extraction correct visé, volume mensuel traité.
- Collectez, anonymisez et annotez vos données d'exemple. Cette étape est souvent sous-estimée : sans un jeu de données représentatif et correctement étiqueté, le modèle reproduira les biais et les incohérences déjà présents dans vos processus manuels. Avant même d'automatiser, il faut formaliser les règles métier existantes, faute de quoi l'IA hérite des mêmes zones d'ombre que le traitement humain qu'elle remplace.
- Choisissez votre approche technique entre un modèle finement ajusté (finetuning), des règles métier explicites ou des instructions données à un modèle génératif (prompts), puis testez et itérez rapidement. La recommandation qui revient le plus souvent chez les praticiens du secteur consiste à démarrer petit, mesurer, puis industrialiser progressivement plutôt que de viser l'exhaustivité dès le premier déploiement, une approche que documente H2O.ai.
- Déployez, surveillez et prévoyez un plan de repli. Un pipeline en production a besoin d'un monitoring continu de ses métriques de précision, d'un mécanisme d'alerte en cas de dérive du modèle, et d'une procédure de retour arrière si une mise à jour dégrade les performances.
Les KPIs à suivre dès la phase pilote sont concrets : taux d'extraction correcte par champ, pourcentage de documents nécessitant une révision manuelle, temps moyen de traitement par document, et coût par document traité comparé au processus manuel antérieur. Databricks recommande d'ailleurs de coupler ces métriques à un monitoring continu incluant precision, recall et score F1, avec des seuils de confiance ajustés en fonction de la criticité du document traité, comme détaillé dans son analyse.
Ne sautez pas l'étape d'annotation sous prétexte de gagner du temps : c'est l'investissement qui conditionne tout le reste du projet.
Quelle architecture choisir pour héberger l'IA documentaire ?
Le choix d'hébergement conditionne directement votre niveau de contrôle sur les données et vos coûts d'exploitation. Trois options structurent le marché : le cloud public, l'hébergement on-premise, et l'architecture hybride.
Le cloud public offre une mise en route rapide et une scalabilité immédiate, mais implique souvent un transfert de données vers des serveurs situés hors de votre juridiction, un point sensible pour toute organisation soumise à la nLPD suisse ou traitant des données de santé, financières ou juridiques. L'hébergement local (on-premise) garantit un contrôle maximal sur la localisation des données et l'auditabilité, au prix d'une charge opérationnelle plus lourde et d'une scalabilité moins immédiate. L'architecture hybride combine les deux : traitement sensible en local, capacités de calcul additionnelles en cloud pour les pics de charge.
Techniquement, un pipeline de Document AI assemble généralement les briques suivantes :
- Un moteur d'OCR pour la reconnaissance de texte et de mise en page.
- Un moteur d'extraction (règles, modèles finement ajustés ou modèles génératifs) pour structurer les champs.
- Un espace de stockage vectoriel (embedding store) pour permettre la recherche sémantique et le questionnement en langage naturel.
- Une couche d'orchestration qui enchaîne les étapes, gère les erreurs et déclenche les validations humaines.
L'intégration aux systèmes existants reste souvent le point le plus sous-estimé d'un projet. Un pipeline performant ne vaut rien s'il reste isolé de votre système de gestion documentaire (DMS), de votre ERP, ou de votre entrepôt de données. L'intégration avec un entrepôt comme BigQuery permet par exemple d'exposer les données extraites directement aux équipes analytiques, sans étape de ressaisie intermédiaire. Cette logique d'intégration profonde aux processus métiers se retrouve aussi côté ERP, où l'IA agentique appliquée à des systèmes comme Dynamics 365 illustre comment automatiser des flux complets plutôt que des tâches isolées.
Comment sécuriser et gouverner les documents traités par IA ?
La sécurité d'un pipeline documentaire ne se résume pas à un chiffrement des fichiers. Elle englobe le contrôle des accès, la traçabilité des traitements, et la localisation même des données.
Les contrôles techniques minimaux à mettre en place comprennent :
- Le chiffrement des données au repos et en transit, sans exception pour les environnements de test.
- Une gestion des identités et des accès (IAM) avec des rôles définis selon le principe du moindre privilège.
- Une journalisation complète de chaque traitement, exportable pour un audit externe.
- Des clauses contractuelles claires sur tout transfert international de données, avec vérification du cadre juridique applicable.
La souveraineté numérique n'est pas qu'une contrainte technique : c'est une décision stratégique qui conditionne vos choix d'hébergement, vos contrats fournisseurs et votre gouvernance interne, comme le souligne l'analyse de Swisscom sur le sujet. Pour une organisation suisse, la question se pose en des termes concrets : où vos documents transitent-ils réellement, et sous quelle juridiction ?
En bref : une entreprise soumise à la nLPD doit pouvoir démontrer, pas seulement affirmer, que ses données de traitement documentaire restent sous contrôle suisse, avec des contrats prévoyant l'absence de transfert vers des juridictions tierces sans garanties équivalentes.
Le principe du privacy by design s'applique aussi à l'entraînement des modèles : les jeux de données servant au finetuning doivent être anonymisés en amont, jamais après coup. C'est particulièrement vrai pour les secteurs traitant des données de santé ou des dossiers juridiques, où le détail des garanties de sécurité d'une plateforme devient un critère de sélection à part entière, au même titre que la précision technique du modèle.
Quelles sont les limites de l'IA documentaire, et comment les valider ?
Aucun système de Document AI n'atteint une fiabilité absolue, et le prétendre serait trompeur. Les erreurs les plus fréquentes viennent de documents dégradés (scans de mauvaise qualité, écritures manuscrites), de formats jamais vus pendant l'entraînement, ou de biais hérités des données d'annotation initiales.
Pour valider la qualité d'un pipeline, plusieurs métriques s'imposent :
- La précision (precision) : la part des extractions correctes parmi celles proposées par le modèle.
- Le rappel (recall) : la part des informations réellement présentes dans le document que le modèle a su retrouver.
- Le score F1, qui équilibre les deux précédents pour donner une vision globale de la performance.
- Le taux de couverture, c'est-à-dire la proportion de documents traités sans intervention humaine.
Databricks rappelle que ces métriques doivent s'accompagner d'un monitoring continu, car un modèle performant à son lancement peut dériver avec le temps si la nature des documents entrants évolue, une dynamique bien documentée dans son analyse. H2O.ai va dans le même sens en soulignant que l'accuracy d'un système dépend autant de la solidité du pipeline que de la présence d'une validation humaine sur les cas incertains, un point central de sa description du domaine.
Conseil de pro : Fixez un seuil de confiance strict pour les documents sensibles (contrats juridiques, dossiers médicaux) et un seuil plus souple pour les documents à faible enjeu. Un même seuil unique pour tous vos cas d'usage est presque toujours une erreur de conception.
Pourquoi la preuve technique compte plus que la promesse marketing
La plupart des discours sur l'IA documentaire vendent la vitesse. Peu parlent de la preuve. Chez Nectos, notre conviction est que la vraie valeur de l'IA sur documents ne se mesure pas à sa capacité à extraire vite, mais à sa capacité à prouver où vos données ont été traitées, par quel modèle, et sous quelle juridiction.
C'est pour cette raison que Nectos héberge exclusivement en Suisse, sous conformité nLPD, avec des journaux d'audit exportables plutôt qu'une simple promesse de confidentialité. Avant de choisir un outil, exigez de voir ses garanties techniques, pas seulement ses fonctionnalités affichées. Commencez petit, sur un cas d'usage interne à faible risque, et mesurez la traçabilité autant que la précision.
— Adopt
Une plateforme d'IA documentaire qui reste sous juridiction suisse
Nectos est l'alternative souveraine aux plateformes documentaires hébergées à l'étranger : vos contrats, factures et rapports restent traités sur des serveurs suisses, jamais partagés avec des géants technologiques américains.

Concrètement, l'espace de travail Nectos réunit une analyse intelligente de documents, une base de connaissances privée et un assistant IA capable de résumer, classer et interroger vos fichiers, le tout sans que vos données ne quittent le territoire suisse. Chaque traitement est journalisé, chaque accès tracé, et l'ensemble reste conforme à la nLPD, un point que Nectos ne se contente pas d'affirmer mais documente concrètement sur sa page dédiée à la sécurité. Pour une entreprise réglementée (juridique, santé, finance), cette auditabilité pèse souvent plus lourd que quelques secondes de traitement gagnées ailleurs.
Découvrez l'ensemble des fonctionnalités disponibles sur la page produit de Nectos, ou consultez directement les garanties de souveraineté suisse avant de lancer votre premier projet pilote.
Sources
Pour approfondir les aspects techniques abordés ici, trois ressources font référence dans le domaine. La présentation d'IBM sur le Document AI détaille les fondements techniques du domaine, entre OCR, apprentissage automatique et traitement du langage naturel. L'analyse de Databricks couvre les cas d'usage sectoriels et les métriques de validation. Le wiki de H2O.ai offre une vue d'ensemble des composants du pipeline et de leurs limites pratiques. Sur la dimension souveraineté, l'analyse de Swisscom éclaire pourquoi la localisation des données conditionne le succès des projets d'IA en entreprise.
Questions fréquentes
Comment utiliser l'IA sur un document concret ?
Il suffit généralement de téléverser le document dans une plateforme dotée d'un moteur d'extraction, de vérifier les champs proposés avec leur score de confiance, puis de valider ou corriger les résultats incertains avant intégration dans vos systèmes.
Qu'est-ce que la règle des 30 % en IA ?
Cette règle n'est pas un standard technique reconnu dans le domaine du Document AI ; les définitions varient selon les contextes, et aucune source du secteur ne l'établit comme principe universel applicable au traitement documentaire.
Quelle est la meilleure IA pour traiter des documents ?
Il n'existe pas de réponse unique : le bon choix dépend de vos contraintes de conformité, du type de documents traités et de vos exigences de souveraineté des données. Pour les organisations suisses soumises à la nLPD, une plateforme hébergée localement comme Nectos répond à des critères qu'un outil cloud étranger ne peut pas garantir par contrat.
Combien coûte une solution de Document AI ?
Les coûts varient fortement selon le volume de documents, la complexité d'intégration et le modèle d'hébergement choisi (cloud, on-premise ou hybride) ; aucun chiffre unique ne s'applique à tous les cas, mieux vaut demander un devis basé sur votre volume réel.