Le verdict tient en une règle simple. Si vos données peuvent être centralisées dans un index unique et que vous visez une latence inférieure à la seconde, un RAG indexé classique reste le choix le plus efficace. Si vos données sont réglementées, dispersées entre plusieurs systèmes ou juridiquement impossibles à déplacer, la recherche fédérée appliquée au RAG (federated RAG) devient la seule option réaliste, à condition d'y ajouter un routage intelligent des sources.
Le RAG (génération augmentée par récupération) combine un moteur de recherche documentaire avec un modèle de langage qui rédige la réponse finale. La recherche fédérée, elle, désigne une méthode d'interrogation : au lieu d'un index unique, on interroge plusieurs sources en direct et on agrège leurs résultats.
Ce qui a changé récemment, ce sont les preuves chiffrées. Des travaux comme RAGRoute montrent qu'un routage léger peut réduire considérablement le volume de communication et la latence d'un pipeline fédéré, sans sacrifier la pertinence des réponses.
- RAG indexé : rapide, cohérent, mais exige de centraliser les données en amont.
- Recherche fédérée pour RAG : plus lente par nature, mais respecte la localisation et la propriété des données sources.
- Federated RAG avec routage : combine les deux logiques en interrogeant uniquement les sources pertinentes.
Points clés
Le choix entre RAG indexé et federated RAG dépend avant tout de la sensibilité et de la dispersion des données, pas d'une préférence technologique.
| Point | Détails |
|---|---|
| Centraliser quand c'est possible | Un RAG indexé offre une latence sub-seconde une fois l'index construit, mais exige un travail d'ingestion continu. |
| Fédérer quand la donnée ne peut pas bouger | La recherche fédérée devient nécessaire quand les connaissances sont dispersées et la centralisation impraticable. |
| Router plutôt qu'interroger tout | Un routeur léger type RAGRoute réduit fortement le volume de communication et la latence sans perdre en précision. |
| Le reranking est le vrai coût | Réduire le nombre de sources interrogées diminue le temps de reranking, souvent le vrai goulot d'étranglement. |
| La souveraineté guide l'architecture | La nLPD pousse les organisations suisses régulées vers des schémas hybrides indexé-fédéré. |
Table des matières
- Recherche fédérée vs RAG : définitions et périmètres
- Comment fonctionne le pipeline de récupération dans chaque approche ?
- Que montrent les recherches récentes sur RAGRoute et la recherche fédérée ?
- Recherche fédérée ou RAG indexé : quels sont les compromis réels ?
- Quels patterns d'architecture pour concilier souveraineté et performance ?
- Quelle checklist suivre avant de lancer un POC fédéré ?
- Pourquoi la souveraineté des données oriente le choix d'architecture
- Ce que les décideurs sous-estiment dans ce débat
- Sources
- Questions fréquentes
Recherche fédérée vs RAG : définitions et périmètres
Trois termes circulent souvent sans distinction claire, ce qui crée de la confusion chez les équipes techniques qui évaluent une architecture.
La recherche fédérée consiste à interroger simultanément plusieurs systèmes de données indépendants (bases documentaires, CRM, entrepôts juridiques) sans jamais les fusionner dans un index central. Chaque source répond à sa manière, puis les résultats sont agrégés.
Le RAG (retrieval-augmented generation) est un pipeline en deux temps : on récupère des documents pertinents, puis un modèle de langage génère une réponse à partir de ces documents. Un RAG n'est pas synonyme de recherche vectorielle : la recherche vectorielle (ou recherche sémantique) n'est qu'une des méthodes possibles pour l'étape de récupération. On peut tout aussi bien y injecter une recherche par mots-clés, une recherche fédérée ou une combinaison des deux.
Le federated RAG est simplement un RAG dont la couche de récupération repose sur une architecture fédérée plutôt que sur un index unique. C'est ici que se joue la vraie décision d'architecture :
- Un RAG classique utilise un index vectoriel préconstruit et centralisé.
- Un federated RAG interroge des sources hétérogènes en temps réel, sans les avoir toutes pré-indexées.
- La recherche fédérée peut alimenter un RAG, mais elle existe aussi indépendamment de tout modèle génératif, par exemple dans les moteurs de recherche d'entreprise classiques.
Comment fonctionne le pipeline de récupération dans chaque approche ?
Un RAG indexé suit une séquence prévisible. Les documents sont d'abord découpés en fragments, transformés en vecteurs (embeddings), puis stockés dans une base vectorielle optimisée pour la recherche par approximation du plus proche voisin (ANN). Au moment de la requête, le système récupère les fragments les plus proches sémantiquement, les reclasse via un reranker, puis les injecte dans le prompt envoyé au modèle.
La recherche fédérée applique une logique différente, en quatre étapes :
- Sélection des sources : identifier quelles bases interroger parmi celles disponibles, plutôt que de tout consulter.
- Requêtes en direct : envoyer la question à chaque source retenue, souvent via des API distinctes avec des formats de réponse différents.
- Agrégation des résultats : fusionner des listes hétérogènes provenant de systèmes qui ne partagent pas le même schéma de scoring.
- Normalisation des scores : ramener ces scores disparates sur une échelle comparable avant de les transmettre au reranker.
Cette dernière étape est souvent sous-estimée. Sans normalisation rigoureuse, un document peu pertinent mais bien classé par une source mal calibrée peut écraser un résultat pertinent venu d'une autre source.
Le reranking pèse lourd dans le coût final, quelle que soit l'architecture. Interroger indistinctement toutes les sources disponibles augmente le volume de documents à reclasser et peut accroître les hallucinations en injectant du contexte non pertinent dans le prompt final. C'est précisément le problème que le routage de sources cherche à résoudre.
Que montrent les recherches récentes sur RAGRoute et la recherche fédérée ?
Les papiers publiés depuis 2024 apportent enfin des chiffres concrets là où le débat restait largement théorique. RAGRoute propose un routeur léger, un petit réseau de neurones entraîné à prédire quelles sources contiennent probablement une réponse utile, sans avoir besoin d'interroger l'ensemble du réseau fédéré.
Chiffres clés : sur trois benchmarks, RAGRoute réduit significativement le volume de communication et la latence de bout en bout, tout en maintenant une précision comparable à une interrogation exhaustive de toutes les sources.
Le gain ne vient pas principalement de la recherche vectorielle elle-même. Il vient surtout de la réduction du nombre de documents à reranker, qui reste souvent le vrai goulot d'étranglement du pipeline. Dans certains scénarios rapportés, le temps de reranking passe d'une durée élevée à une durée nettement réduite une fois le routage appliqué.
Ces résultats s'accompagnent de limites qu'il faut garder en tête avant de les généraliser :
- Les benchmarks testés couvrent un nombre restreint de domaines, pas l'ensemble des cas d'usage d'entreprise.
- Le rappel de sélection de sources (la capacité à identifier les bonnes sources) atteint des niveaux élevés dans les papiers publiés, mais reste dépendant de la qualité de l'entraînement du routeur.
- Les gains de latence supposent que le routeur lui-même reste peu profond ; un routeur trop complexe peut annuler une partie du bénéfice.
En pratique, un point d'entrée à mesurer en preuve de concept (POC) est simple : combien de sources sur dix votre routeur élimine-t-il correctement, et quel est l'impact sur le temps de reranking observé ?
Recherche fédérée ou RAG indexé : quels sont les compromis réels ?
Le choix ne se résume jamais à une préférence technique. Il dépend de quatre variables concrètes que tout décideur devrait poser avant de lancer un projet.
- Sensibilité et localisation des données : des dossiers clients réglementés ou des données de santé ne peuvent souvent pas quitter leur système d'origine.
- Dispersion des sources : plus les connaissances pertinentes sont éclatées entre systèmes hétérogènes, plus la fédération devient nécessaire car la centralisation est impraticable pour des raisons réglementaires ou opérationnelles.
- Exigence de fraîcheur : une base fédérée interroge la donnée en direct, ce qui évite le décalage d'un index rafraîchi périodiquement.
- Budget de latence et coût d'ingestion : un RAG indexé offre généralement une latence sub-seconde une fois l'index construit, mais ce gain se paie par un travail d'ingestion continu.
Le risque principal de la fédération n'est pas la lenteur en soi, c'est la fragmentation. Agréger des scores venus de systèmes qui ne parlent pas le même langage introduit un risque de « contexte empoisonné » si la normalisation est bâclée, et certaines analyses notent que la fédération produit souvent des listes de résultats fragmentées plutôt qu'une réponse contextualisée unique.
Conseil de pro : *avant d'investir dans un routeur complet type RAGRoute, testez d'abord une indexation partielle des sources non sensibles.
Quels patterns d'architecture pour concilier souveraineté et performance ?
Deux schémas dominent les implémentations d'entreprise les plus solides, et ils ne s'excluent pas mutuellement.
Le premier, dit brokered multi-stage, sépare le pipeline en trois étages : un routeur sélectionne les sources probablement pertinentes, un retrieval hybride combine recherche par mots-clés (sparse) et recherche sémantique (dense) sur ces sources, puis un reranking hiérarchique affine le classement final avant de nourrir le modèle génératif.
Le second, l'hybride indexé-fédéré, consiste à indexer classiquement tout ce qui n'est pas sensible, et à ne fédérer que les sources soumises à des contraintes de localisation ou de confidentialité. C'est souvent le compromis opérationnel le plus réaliste pour une organisation régulée.
Sur le plan technique, la gestion des droits d'accès (ACL) mérite une attention particulière :
- Le bitset caching permet de vérifier rapidement quels documents un utilisateur donné peut voir, sans requête coûteuse à chaque appel.
- Le late binding applique les filtres d'autorisation après la recherche brute, plutôt qu'en amont, pour ne pas fausser le scoring.
- Le filtered HNSW intègre directement les contraintes d'accès dans la structure d'index vectoriel, évitant un filtrage coûteux en aval.
- Un monitoring continu du rappel utile et des métriques de latence permet de détecter une dérive avant qu'elle n'affecte les utilisateurs finaux.
Ces briques recoupent des logiques déjà connues des architectures de knowledge graph, où relier plusieurs sources hétérogènes en un graphe interrogeable pose des défis similaires de normalisation et de gouvernance.
Quelle checklist suivre avant de lancer un POC fédéré ?
Trois métriques suffisent pour juger si une architecture fédérée tient ses promesses en conditions réelles : la latence de bout en bout mesurée sur requête utilisateur réelle, le coût par requête (nombre de sources interrogées multiplié par le coût de reranking), et le rappel utile, c'est-à-dire la proportion de réponses correctes réellement retrouvées.
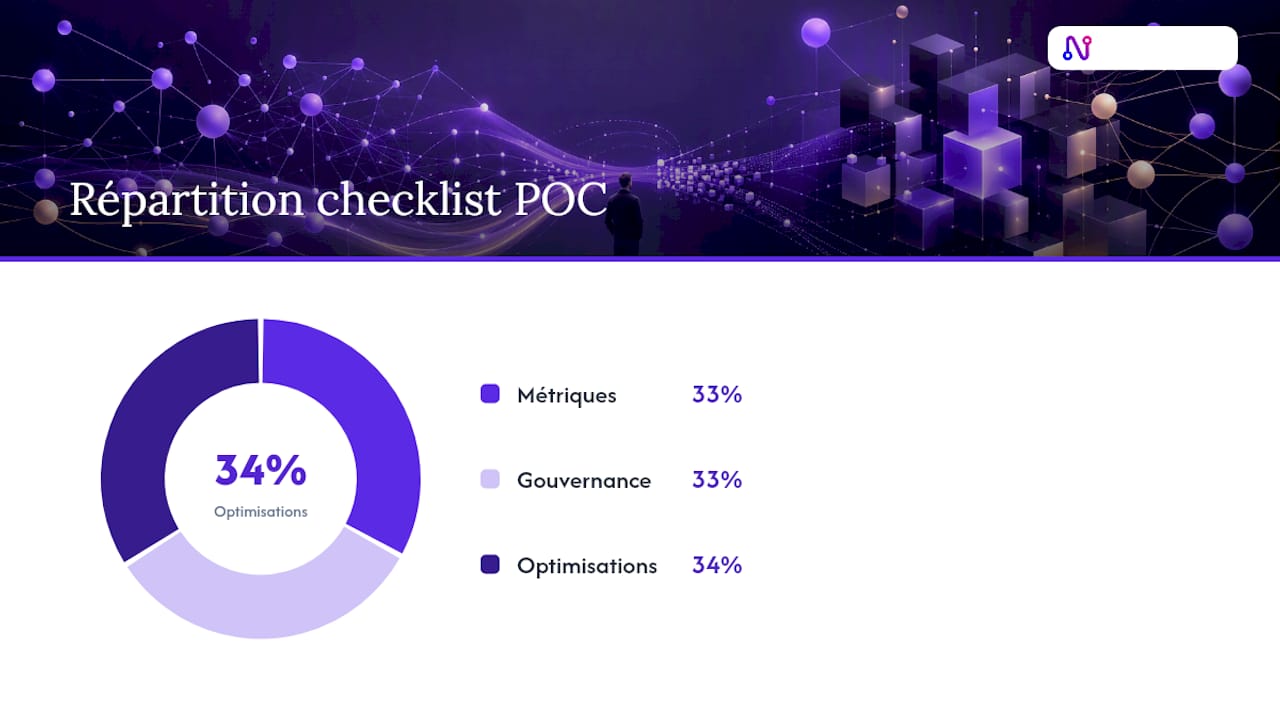
Côté gouvernance, une checklist minimale couvre la provenance des documents cités (quelle source a produit quel fragment), la conservation de journaux d'audit complets, et la capacité à démontrer, en cas de contrôle, quel utilisateur a eu accès à quelle donnée et quand.
Sur le plan des optimisations, trois leviers reviennent systématiquement dans les implémentations qui tiennent la charge :
- Mettre en cache les résultats de sources stables pour éviter des appels API répétés inutiles.
- Fixer un budget de sources maximum par requête plutôt que de laisser le système interroger tout le réseau.
- Préférer un reranker léger en première passe, réservé pour un second passage plus coûteux uniquement sur le sous-ensemble déjà filtré.
Conseil de pro : dimensionnez votre routeur sur le trafic réel, pas sur un jeu de test académique. Réentraînez-le dès que la distribution des requêtes change sensiblement, par exemple après l'ajout d'une nouvelle source documentaire ou un changement d'usage métier.
Pourquoi la souveraineté des données oriente le choix d'architecture
En Suisse, la nLPD impose des règles strictes sur la localisation et le traitement des données personnelles, ce qui rend la centralisation hors frontières juridiquement risquée pour de nombreux secteurs régulés. Pour une entreprise soumise à ces contraintes, la recherche fédérée n'est pas qu'une option technique : elle devient souvent le seul moyen de construire un RAG fonctionnel sans déplacer de données sensibles hors de leur périmètre d'origine.
C'est exactement le terrain sur lequel opère Nectos, un espace de travail IA hébergé uniquement sur des serveurs suisses, conçu pour que les données ne transitent jamais vers des infrastructures étrangères.
Concrètement, cela se traduit par :
- Une base de connaissances privée qui reste hébergée en Suisse, sans transfert transfrontalier.
- Un contrôle d'accès administrateur et une gestion de rôles qui répondent directement aux exigences d'auditabilité évoquées plus haut.
- Des journaux d'audit exportables, utiles pour démontrer la conformité en cas de contrôle réglementaire.
Pour approfondir ces mécanismes, la page souveraineté suisse de Nectos détaille le cadre légal, et la page flux de données explique comment l'information circule concrètement dans la plateforme.
Ce que les décideurs sous-estiment dans ce débat
La plupart des comparatifs traitent recherche fédérée et RAG comme deux camps opposés, alors que les preuves récentes disent l'inverse : la vraie question n'est pas laquelle choisir, mais où placer la frontière entre ce qui peut être indexé et ce qui doit rester fédéré. Les chiffres de RAGRoute sont convaincants, mais ils masquent une réalité plus simple : le vrai goulot d'étranglement, dans la quasi-totalité des architectures RAG, c'est le reranking, pas la recherche elle-même.
Ce que je trouve sous-estimé, c'est le coût caché de la normalisation des scores. Les équipes se concentrent sur le choix de l'embedding ou du reranker, alors que la fusion de résultats hétérogènes est souvent l'endroit où les projets fédérés échouent silencieusement, en produisant des réponses subtilement biaisées sans erreur visible.
Pour un décideur suisse, la priorité n'est donc pas de choisir un camp, mais de cartographier précisément quelles données peuvent être centralisées sans risque juridique, et de ne fédérer que le reste. C'est une décision de gouvernance avant d'être une décision d'ingénierie.
— Adopt
Sources
- Efficient Federated Search for Retrieval-Augmented Generation using Lightweight Routing — arXiv
- Federated RAG Architectures for Distributed Enterprise Knowledge Systems — JISEM
Questions fréquentes
Que signifie la recherche fédérée ?
La recherche fédérée consiste à interroger simultanément plusieurs sources de données indépendantes en temps réel, puis à agréger leurs résultats, sans jamais les fusionner dans un index central unique.
Le RAG est-il simplement une recherche vectorielle ?
Non. La recherche vectorielle n'est qu'une méthode possible pour l'étape de récupération d'un RAG ; le pipeline complet inclut aussi la génération de réponse par un modèle de langage à partir des documents récupérés.
Quelle différence entre RAG et recherche sémantique ?
La recherche sémantique identifie des documents pertinents par similarité de sens, tandis que le RAG utilise ces documents comme contexte pour qu'un modèle génère une réponse rédigée, pas seulement une liste de résultats.
Le RAG fait-il partie du traitement automatique du langage ?
Oui, le RAG s'appuie sur des techniques de traitement automatique du langage (TAL), notamment pour l'encodage sémantique des requêtes et la génération de texte par le modèle final.