Le red teaming LLM consiste à simuler des attaques adversariales structurées contre un système de langage pour identifier et prioriser ses vulnérabilités avant sa mise en production. L'exercice produit un inventaire de failles classées par sévérité et un plan de correction concret, aligné sur des référentiels reconnus comme le NIST AI Risk Management Framework et l'OWASP Top 10 pour les applications LLM. Sans cette étape, une entreprise déploie un modèle dont elle ignore les points de rupture.
En bref:
- Le red teaming LLM permet d'identifier et de prioriser les vulnérabilités en produisant un inventaire classé par sévérité, selon une méthodologie en phases.
- Les risques majeurs incluent la divulgation de données sensibles, l'exécution d'actions non autorisées ou la génération de recommandations biaisées, via des attaques telles que l'injection de prompts ou les jailbreaks.
- Un programme efficace combine automatisation pour la couverture large et expertise humaine pour la créativité, avec un re-test indépendant pour valider les corrections.
- La conformité à la nLPD nécessite un hébergement sur une plateforme souveraine, avec anonymisation des données, notamment pour les journaux d'audit et prompts, dans un espace hébergé en Suisse.
- La fréquence des red teamings doit être liée aux changements du modèle ou de l'implémentation, en intégrant un suivi continu pour prévenir toute régression de sécurité.
Table des matières
- Pourquoi le red teaming des LLM est important pour les équipes de sécurité
- Comment fonctionne un programme de red teaming LLM (méthodologie en phases)
- Taxonomie des menaces spécifiques aux LLM
- White‑box vs black‑box : implications pratiques pour les scénarios de test
- Étapes pratiques pour organiser et exécuter un engagement de red teaming LLM
- Mesure, triage, reporting : comment classer les résultats et conduire la remédiation
- Outils, automatisation et ressources pour la largeur et la profondeur des tests
- Considérations de souveraineté et conformité (nLPD) pour la conception des tests
- Perspective de l'équipe : limites actuelles du red teaming LLM
- Envisager un espace de travail IA conforme à la nLPD pour vos tests
- Sources
- Questions fréquentes
Pourquoi le red teaming des LLM est important pour les équipes de sécurité
Un modèle de langage qui passe tous les tests fonctionnels peut malgré tout révéler des données confidentielles, halluciner une réponse juridique erronée ou se laisser manipuler par un jeu de rôle. Le red teaming donne une mesure quantitative de ce risque avant qu'il ne se matérialise en production, ce qui change tout pour une direction de la sécurité qui doit justifier ses arbitrages budgétaires.
Les systèmes les plus exposés ne sont pas les chatbots isolés, mais les architectures RAG (génération augmentée par récupération) et les agents autonomes capables d'exécuter des actions. Un agent connecté à une base documentaire interne peut, sous prompt injection, exfiltrer des extraits qu'il ne devrait jamais divulguer.
Les risques concrets couverts par un programme de red teaming incluent :
- La divulgation de données personnelles ou de secrets professionnels via une réponse détournée est un risque important à considérer.
- L'exécution d'actions non autorisées par un agent manipulé (envoi d'e‑mails, modification de fichiers) peut compromettre la sécurité opérationnelle.
- Des recommandations biaisées dans des contextes RH ou financiers à fort enjeu.
- Une atteinte à la conformité nLPD lorsque les journaux de test eux‑mêmes contiennent des données sensibles mal gérées.
Ces constats institutionnels rejoignent l'analyse du CYD Campus sur les risques que l'IA générative fait peser sur la cybersécurité des organisations.
Comment fonctionne un programme de red teaming LLM (méthodologie en phases)
Un engagement sérieux suit une méthodologie en phases, jamais une série d'essais improvisés. Le NIST IR 8596 formalise cette approche pour les tests adversariaux sur les systèmes d'IA, et Microsoft en propose une déclinaison opérationnelle en trois temps.
- Cadrage : définir le périmètre, les rôles (opérateurs, arbitres, propriétaires du système) et les métriques de succès avant la première attaque.
- Génération d'attaques : combiner des scénarios manuels, créatifs, avec des outils automatisés capables de tester des milliers de variantes de prompts, en single‑turn comme en multi‑turn.
- Exécution en environnement contrôlé : chaque tentative, réussie ou non, est journalisée avec horodatage, prompt exact et réponse du modèle.
- Boucle de correction : triage des résultats, application des mitigations, puis re‑test ciblé sur les mêmes scénarios pour vérifier la fermeture de la faille.
Conseil de pro : ne clôturez jamais un cycle de red teaming sur la seule correction déclarée par l'équipe produit. Exigez un re‑test indépendant avec les mêmes prompts qui ont initialement fonctionné, sinon vous validez une correction sur parole.
Cette boucle rejoint ce que recommandent les guides pratiques récents sur le red teaming des LLM, qui insistent sur la reproductibilité comme condition de crédibilité du test.
Taxonomie des menaces spécifiques aux LLM
Classer les attaques par famille permet de cartographier la couverture réelle d'un programme de tests et d'éviter les angles morts.
- Prompt injection : instructions malveillantes insérées dans un contenu externe (document, page web, e‑mail) que le modèle traite comme une commande légitime. Les variantes directes ciblent l'utilisateur final, les variantes indirectes visent les pipelines RAG.
- Jailbreak : contournement des garde‑fous par jeu de rôle, obfuscation de mots interdits, ou manipulation progressive sur plusieurs tours de conversation. Les attaques multitours restent parmi les plus difficiles à détecter, car chaque message isolé paraît anodin.
- Fuite d'information : extraction de données d'entraînement, de prompts système ou de documents indexés dans une base de connaissances, souvent via des requêtes formulées comme des demandes de résumé ou de traduction.
- Hallucinations à fort enjeu : réponses factuellement fausses dans des contextes médicaux, juridiques ou financiers, où l'erreur a un coût réel pour l'utilisateur final.
- Biais : discrimination systématique dans des recommandations RH, de crédit ou d'assurance, souvent invisible tant que le test ne cible pas spécifiquement des groupes protégés.
L'OWASP Top 10 pour les LLM structure cette taxonomie et propose des contre‑mesures pour chaque catégorie, ce qui en fait une référence de départ plutôt qu'un inventaire à réinventer. Intégrer une taxonomie reconnue au périmètre initial évite de tester au hasard et donne une base de comparaison entre deux engagements successifs.
White‑box vs black‑box : implications pratiques pour les scénarios de test
Le niveau d'accès dont dispose l'équipe de test change radicalement la nature des attaques possibles.
- Black‑box : l'équipe n'a accès qu'à l'interface publique, exactement comme un attaquant externe. Elle privilégie les manipulations de prompt, le jailbreak conversationnel et les tests de fuite via les réponses observables.
- White‑box : l'accès aux poids du modèle, au prompt système et aux journaux internes permet des attaques par gradient, l'inspection directe des instructions cachées et une analyse fine des mécanismes de filtrage.
- Gris (accès partiel) : accès aux logs applicatifs sans les poids du modèle, situation la plus fréquente pour une équipe interne testant un LLM fourni par un tiers.
En phase de développement précoce, le mode white‑box accélère la découverte de failles structurelles. En phase de préproduction, le black‑box reproduit fidèlement les conditions réelles d'exploitation par un attaquant externe.
Étapes pratiques pour organiser et exécuter un engagement de red teaming LLM
Organiser un test efficace demande un plan d'action, pas une improvisation guidée par l'urgence.
- Fixez des objectifs mesurables : nombre de scénarios testés, taux de contournement des garde‑fous, temps moyen de détection d'une faille. Sans ces KPI, impossible de comparer deux cycles de test.
- Construisez vos scénarios en couvrant le single‑turn (une seule requête malveillante), le multi‑turn (manipulation progressive) et les intégrations tierces (plugins, agents, appels d'API).
- Choisissez l'environnement d'exécution : un sandbox isolé limite les dégâts collatéraux, mais un environnement proche de la production révèle des failles qu'un sandbox simplifié ne reproduit jamais. Anonymisez systématiquement les données utilisées dans les scénarios pour éviter toute exposition de données réelles pendant le test lui‑même.
- Dosez automatisation et revue humaine : les outils automatisés couvrent la largeur (des milliers de variantes de prompts), les experts humains apportent la créativité nécessaire pour découvrir les scénarios que personne n'avait anticipés.
Conseil de pro : réservez toujours une part du budget de test à des scénarios rédigés par des experts métier (juristes, médecins, RH selon votre secteur), pas uniquement par des ingénieurs sécurité. Les hallucinations les plus dangereuses se cachent dans les détails que seul un spécialiste du domaine repère.
Une combinaison d'automatisation pour la couverture et d'experts humains pour la créativité d'attaque donne, selon les guides pratiques récents sur le red teaming des LLM, la meilleure valeur opérationnelle pour un budget donné.
Mesure, triage, reporting : comment classer les résultats et conduire la remédiation
Chaque vulnérabilité découverte doit être notée selon une grille cohérente, sinon le triage devient arbitraire et les priorités de correction dérivent vers les failles les plus visibles plutôt que les plus critiques.
- Impact : conséquence métier si la faille est exploitée (fuite de données, action non autorisée, réputation).
- Probabilité : facilité avec laquelle un attaquant non sophistiqué peut reproduire l'attaque.
- Reproductibilité : la faille se déclenche‑t‑elle de façon systématique ou seulement dans des conditions rares ?
| Critère de triage | Question à trancher |
|---|---|
| Impact | Quelle est la gravité métier si la faille est exploitée ? |
| Probabilité | Un attaquant standard peut‑il reproduire l'attaque facilement ? |
| Reproductibilité | La faille se déclenche‑t‑elle à chaque tentative ou de façon aléatoire ? |
| Statut de correction | La mitigation a‑t‑elle été re‑testée avec succès ? |
Le rapport final doit lister chaque vulnérabilité avec son score, le prompt exact ayant permis de la déclencher, la réponse du modèle et la mitigation proposée. La conservation de journaux d'audit détaillés et reproductibles reste indispensable pour démontrer la conformité et pour permettre un triage post‑test rigoureux, un point que le NIST IR 8596 formalise explicitement. Le cycle ne s'arrête jamais à la correction : chaque mitigation appliquée doit être re‑testée avec les mêmes prompts, puis surveillée en continu une fois en production.
Outils, automatisation et ressources pour la largeur et la profondeur des tests
Aucun outil unique ne couvre l'ensemble d'un programme de red teaming LLM. Les équipes efficaces assemblent plusieurs catégories complémentaires plutôt que de dépendre d'une seule plateforme.
- Fuzzers de prompts : génèrent automatiquement des milliers de variantes d'attaques pour tester la robustesse à grande échelle.
- Générateurs adversariaux : produisent des attaques ciblées basées sur des patterns de jailbreak connus et leurs mutations.
- Harnais de test : orchestrent l'exécution des scénarios, capturent les réponses et alimentent le pipeline de triage.
Le critère de sélection le plus négligé reste l'auditabilité : un outil qui ne produit pas de journal exportable et horodaté est inutilisable pour prouver une conformité ultérieure. La compatibilité avec les architectures RAG mérite aussi une vérification préalable, car de nombreux outils génériques ne testent que le modèle seul, sans simuler le pipeline de récupération documentaire qui l'entoure. Intégrer ces tests dans le pipeline d'intégration continue, avec un déclenchement automatique à chaque mise à jour de prompt système, transforme le red teaming d'un exercice ponctuel en un contrôle permanent.
Considérations de souveraineté et conformité (nLPD) pour la conception des tests
Un red teaming LLM génère lui‑même des données sensibles : prompts contenant des informations métier, réponses du modèle, journaux d'audit complets. La localisation de ces données devient une question de conformité à part entière au regard de la nLPD, la loi suisse sur la protection des données.
- Séparez strictement l'environnement de test de l'environnement de production pour éviter toute contamination de données réelles dans les journaux d'audit.
- Anonymisez systématiquement les prompts avant qu'ils ne transitent par un outil tiers, en particulier si celui‑ci est hébergé hors de Suisse.
- Conservez les journaux d'audit sur une infrastructure dont vous pouvez prouver la juridiction, condition indispensable si un régulateur ou un client exige une preuve de traitement conforme.
Un espace de travail IA souverain hébergé exclusivement sur des serveurs suisses facilite cette démonstration, puisque les journaux générés pendant un test restent sous droit suisse du début à la fin du cycle. C'est un argument concret face à un client réglementé qui demande où transitent réellement les données de test.
Perspective de l'équipe : limites actuelles du red teaming LLM
Les outils automatisés couvrent la largeur des attaques connues, mais ils restent aveugles aux scénarios que personne n'a encore documentés. C'est là que l'expertise humaine garde un avantage difficile à automatiser, un constat que confirment les parcours de formation spécialisés comme celui d'OffSec sur le red teaming LLM.
La prochaine génération de défis se déplace vers les agents autonomes, la multimodalité (image, audio, vidéo comme vecteurs d'attaque) et la chaîne d'approvisionnement des modèles eux‑mêmes, un point que confirment les synthèses sectorielles sur les risques IA en 2025. Les équipes qui investissent aujourd'hui dans des scénarios multilingues et métier auront une longueur d'avance quand ces menaces deviendront la norme plutôt que l'exception.
Envisager un espace de travail IA conforme à la nLPD pour vos tests
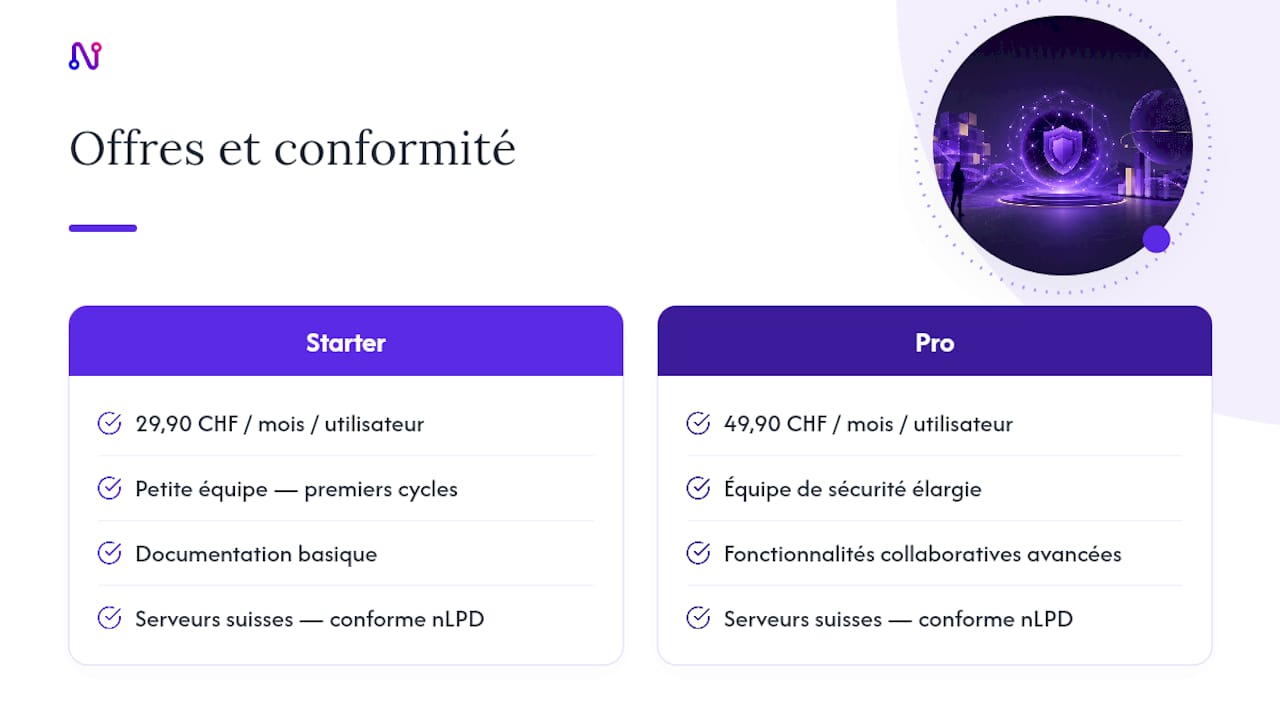
Un programme de red teaming produit des journaux d'audit, des prompts et des réponses qui contiennent souvent des informations métier sensibles. Traiter ces données sur une plateforme hébergée hors de Suisse expose votre organisation à un risque de conformité que les résultats du test eux‑mêmes ne justifient pas. Un espace de travail IA hébergé exclusivement sur des serveurs suisses, conforme à la nLPD, avec anonymisation automatique des prompts et journaux d'audit exportables facilite vos preuves de conformité. L'offre Starter à 29,90 CHF par mois et par utilisateur convient à une équipe qui documente ses premiers cycles de test, tandis que l'offre Pro à 49,90 CHF par mois et par utilisateur ajoute les fonctionnalités collaboratives nécessaires à une équipe de sécurité plus large. Les données client ne sont pas utilisées pour l'entraînement des modèles, et la chaîne de traitement est conçue pour respecter la souveraineté des données, sans intervention de sous‑traitants étrangers.
Sources
Les référentiels normatifs cités dans cet article incluent le NIST AI Risk Management Framework, le NIST IR 8596, l'OWASP Top 10 pour les LLM et la documentation Microsoft sur la planification du red teaming. La taxonomie MITRE ATLAS complète utilement ces référentiels pour cartographier les tactiques adversariales spécifiques aux systèmes d'IA.
- NIST AI Risk Management Framework
- NIST.IR.8596 — Recommendations for Adversarial Testing of AI
- OWASP Top 10 for Large Language Model Applications
Questions fréquentes
Qu'est‑ce que le red teaming LLM concrètement ?
Le red teaming LLM consiste à simuler des attaques structurées contre un modèle de langage pour révéler ses vulnérabilités avant leur exploitation réelle. L'exercice suit une méthodologie en phases inspirée du NIST IR 8596 et produit un rapport de sévérité exploitable.
Quelle différence entre red teaming et tests de sécurité classiques ?
Les tests de sécurité classiques vérifient des vulnérabilités techniques connues (injections SQL, failles réseau), tandis que le red teaming LLM cible des comportements émergents propres au langage naturel, comme le jailbreak ou l'hallucination contextuelle. La taxonomie de l'OWASP Top 10 pour les LLM formalise cette distinction.
Faut‑il privilégier l'automatisation ou les experts humains ?
Les deux sont complémentaires : l'automatisation couvre la largeur des scénarios connus, les experts humains apportent la créativité nécessaire pour découvrir des attaques inédites. Les guides pratiques sur le red teaming des LLM recommandent explicitement cette combinaison plutôt qu'un choix exclusif.
Comment gérer les données sensibles générées pendant un test ?
Anonymisez les prompts avant tout transfert vers un outil tiers et conservez les journaux d'audit sur une infrastructure dont la juridiction est vérifiable. Un espace IA souverain hébergé en Suisse simplifie cette démonstration en gardant les données sous droit suisse.
À quelle fréquence relancer un cycle de red teaming ?
Un nouveau cycle s'impose à chaque changement significatif du modèle, du prompt système ou des intégrations connectées, et non selon un calendrier fixe. Le monitoring continu entre deux cycles permet de détecter une régression avant qu'elle ne s'aggrave.