La meilleure pratique pour anonymiser un prompt consiste à détecter puis pseudonymiser les identifiants sensibles avant l'appel au modèle, tout en conservant un mapping chiffré permettant une restauration interne. Cette substitution contextuelle protège les données personnelles sans sacrifier la cohérence de la réponse, et elle laisse une trace exploitable en cas d'audit. Les étapes techniques et les outils pour y arriver suivent juste après.
En bref:
- La pseudonymisation réversible, combinée à un mapping chiffré séparé, permet de restaurer les données originales tout en garantissant la confidentialité.
- La détection d'entités nommées (NER) est essentielle pour anonymiser efficacement du texte libre ou narratif dans un prompt.
- La mise en œuvre d'un pipeline d'anonymisation doit suivre une séquence structurée incluant cartographie, détection, minimisation et restauration contrôlée.
- L'utilisation d'une plateforme souveraine comme Nectos offre une anonymisation automatisée intégrée, hébergée en Suisse, avec journalisation conforme à la nLPD.
- La stratégie doit allier contrôle technique et gouvernance documentée, notamment en réalisant des analyses d'impact dès que le risque pour la vie privée devient élevé.
Table des matières
- Pourquoi anonymiser les prompts et quel compromis accepter
- Catalogue pratique des techniques d'anonymisation pour prompts
- Étapes concrètes pour intégrer l'anonymisation dans un pipeline LLM
- Familles d'outils et patterns d'intégration pour automatiser l'anonymisation
- Gouvernance, conformité et bonnes pratiques opérationnelles
- Comment une workspace IA souveraine comme Nectos prend en charge l'anonymisation
- Vers une anonymisation qui apprend à préserver l'utilité
- Ce que les équipes sous-estiment dans l'anonymisation des prompts
- Une solution suisse pensée pour l'anonymisation dès la conception
- Sources
- Questions fréquentes
Pourquoi anonymiser les prompts et quel compromis accepter
Un prompt professionnel contient souvent bien plus qu'une simple question. Un nom de client, un numéro de dossier, une adresse email glissée dans le contexte : autant d'éléments qui, une fois envoyés à un modèle de langage, échappent au contrôle direct de l'entreprise. Le risque n'est pas seulement théorique. Une fuite de données personnelles dans un prompt peut engager la responsabilité contractuelle d'une entreprise, déclencher une demande d'accès au sens de la LPD, ou exposer un secret professionnel protégé.
C'est là qu'intervient le compromis privacy-utility : anonymiser trop agressivement rend le prompt inutilisable, car le modèle perd les relations qui donnaient du sens à la demande. Anonymiser trop peu expose des informations qu'on ne peut plus rattraper une fois la requête partie.
Trois priorités guident un arbitrage sain :
- Protéger en priorité les secrets professionnels et les données personnelles identifiantes.
- Conserver les relations contextuelles indispensables à la compréhension (rôles, dates, montants relatifs).
- Accepter une perte de précision mineure plutôt qu'un risque de fuite majeur.
Catalogue pratique des techniques d'anonymisation pour prompts
Il n'existe pas une seule bonne façon d'anonymiser un prompt. Le choix dépend du volume de texte, du type de données et de la tolérance à l'erreur.
Les expressions régulières (regex) restent l'outil le plus rapide à déployer pour des patterns structurés : numéros de téléphone suisses, adresses email, IBAN, numéros AVS. Elles échouent en revanche dès qu'il s'agit de repérer un nom propre isolé dans une phrase ou une organisation citée sans marqueur évident, ce qui génère à la fois des faux négatifs et des faux positifs gênants.
La reconnaissance d'entités nommées (NER) comble cette faiblesse. Un modèle NER identifie les noms de personnes, d'organisations et de lieux même sans structure fixe, ce qui le rend indispensable dès que le prompt contient du texte libre ou narratif.
La pseudonymisation réversible, via un mappage chiffré stocké séparément, permet de remplacer une donnée par un jeton tout en gardant la possibilité de revenir à l'original côté interne. Le caviardage irréversible, à l'inverse, supprime définitivement l'information : plus sûr pour les cas critiques, mais inutilisable si l'équipe a besoin de retrouver le contexte original plus tard.
Le masquage par jetons cohérents (token masking) consiste à remplacer chaque occurrence d'une même entité par le même placeholder tout au long du prompt, par exemple [CLIENT_A] répété plutôt qu'un texte générique. Cela préserve les relations entre entités, ce qui compte énormément pour la qualité de la réponse.
Une étude récente sur l'optimisation des politiques d'anonymisation confirme qu'une approche hybride, combinant règles et NER, capture mieux les patterns simples et les entités complexes qu'une seule méthode isolée.
Conseil de pro : *testez systématiquement la version anonymisée d'un prompt contre sa version originale sur un échantillon représentatif de vos cas d'usage.
Étapes concrètes pour intégrer l'anonymisation dans un pipeline LLM
Déployer une anonymisation fiable en production suit une logique séquentielle assez proche d'un pipeline CI/CD classique.
- Cartographiez les flux de données. Identifiez chaque point où un prompt est créé, transmis, stocké ou journalisé, y compris les logs applicatifs souvent oubliés.
- Définissez une politique de classification. Toutes les données ne méritent pas le même traitement : un numéro de dossier interne n'a pas la sensibilité d'un dossier médical.
- Implémentez la détection en amont de l'appel. Combinez regex et NER pour repérer les identifiants avant que le texte ne quitte votre périmètre.
- Minimisez ce qui est réellement envoyé au modèle. Cette logique d'isolation, recommandée par les experts en conformité IA, limite l'exposition même en cas d'incident côté fournisseur.
- Restaurez en interne, jamais côté modèle. Le mapping chiffré reste sur vos serveurs et permet de reconstituer la réponse finale sans jamais exposer l'original.
- Journalisez et testez en continu. Des tests adversariaux réguliers vérifient qu'aucune fuite ne s'est glissée dans un nouveau format de prompt.
Familles d'outils et patterns d'intégration pour automatiser l'anonymisation
Le choix entre traitement côté navigateur et traitement côté serveur détermine largement votre niveau de contrôle. Une anonymisation côté client réduit les données transmises dès la source, mais complique la cohérence des mappings entre plusieurs sessions ou appareils. Une anonymisation côté serveur centralise le contrôle et facilite l'audit, à condition que l'infrastructure elle-même soit sécurisée et localisée sur un territoire dont vous maîtrisez le cadre juridique.
Les bibliothèques et interfaces en ligne de commande open source restent la porte d'entrée la plus courante pour les équipes techniques : elles s'intègrent facilement dans un pipeline existant et permettent d'itérer sur les règles de détection sans dépendre d'un fournisseur externe.
L'intégration dans une chaîne CI/CD ajoute une couche de sécurité supplémentaire, avec des tests adversariaux qui simulent des tentatives de contournement avant chaque déploiement, comme le suggèrent les travaux récents sur l'évaluation des méthodes d'anonymisation.
Quelques critères méritent une attention particulière avant tout choix d'outil :
- Contrôles d'accès granulaires sur les mappings de pseudonymisation.
- Chiffrement des données au repos et en transit.
- Capacité à exporter les journaux pour un audit de conformité.
- Localisation de l'hébergement et juridiction applicable.
Gouvernance, conformité et bonnes pratiques opérationnelles
L'anonymisation technique ne suffit pas sans une gouvernance documentée. Le principe de privacy by design impose de penser la protection des données dès la conception du flux, pas après coup, et cela suppose une cartographie précise de chaque traitement.
La LPD révisée exige de la transparence sur les finalités et les mécanismes des traitements automatisés, et impose une analyse d'impact relative à la protection des données (DPIA/AIPD) dès qu'un traitement présente un risque élevé pour les personnes concernées.
Conseil de pro : conservez systématiquement une preuve documentée du raisonnement ayant conduit à ne pas réaliser une DPIA lorsque le risque semble faible. Cette trace protège l'entreprise en cas de contrôle.
Quatre chantiers structurent une gouvernance solide :
- Contrats de sous-traitance précisant les obligations du prestataire IA en matière de traitement des données.
- Séparation stricte des environnements de test et de production.
- Politique de rétention limitant la durée de conservation des prompts et de leurs mappings.
- Procédure formalisée pour répondre aux demandes d'accès portant sur des prompts ou des outputs, avec caviardage traçable des données de tiers.
Comment une workspace IA souveraine comme Nectos prend en charge l'anonymisation
Nectos intègre l'anonymisation automatique des prompts directement dans son flux de travail, avant que la requête n'atteigne le modèle. Chaque échange génère un journal d'audit complet, exportable pour répondre aux exigences de traçabilité de la LPD.
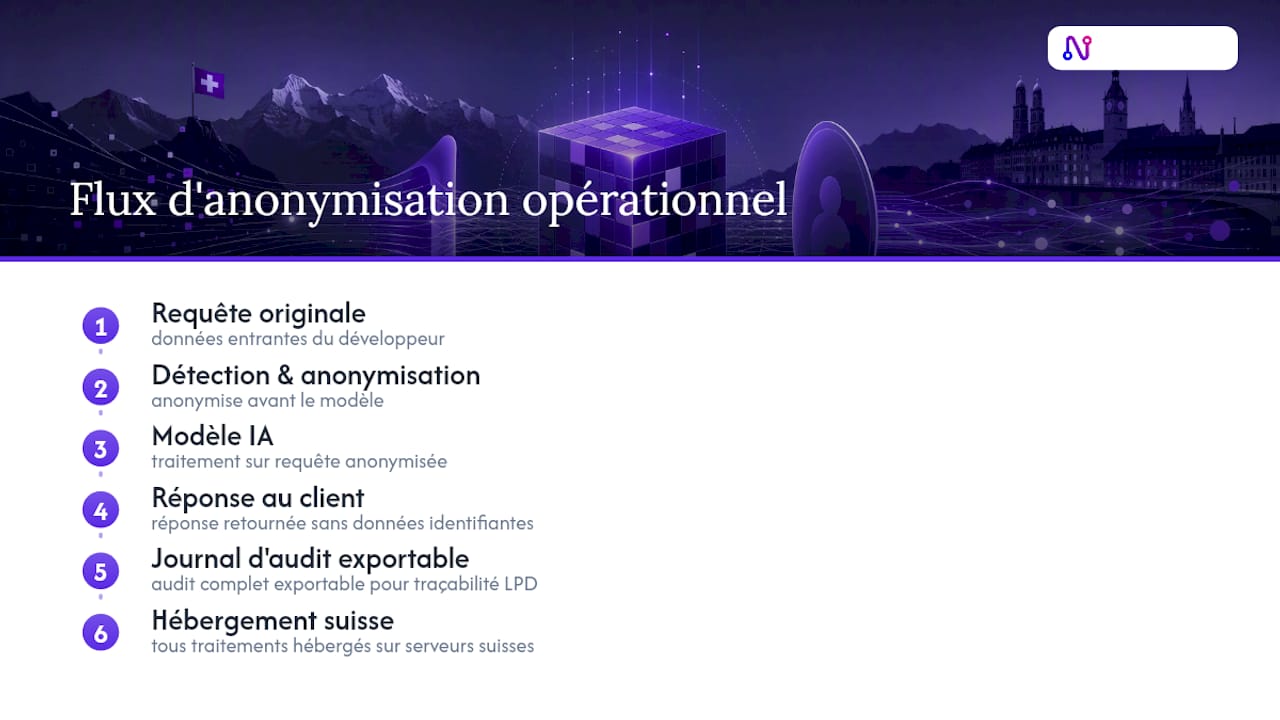
L'ensemble des traitements reste hébergé sur des serveurs suisses, sans transfert vers des géants technologiques américains, ce qui simplifie la démonstration de conformité à la nLPD face à un client ou une autorité. Le dispositif de sécurité de Nectos détaille les contrôles d'accès, la gestion des rôles et les garanties de chiffrement associées à cette architecture souveraine.
Vers une anonymisation qui apprend à préserver l'utilité
Les recherches les plus récentes s'orientent vers des politiques d'anonymisation apprises automatiquement plutôt que fixées par des règles statiques. Un cadre d'optimisation des prompts montre qu'il devient possible d'ajuster dynamiquement le niveau de masquage selon la tâche, en réduisant la fuite d'informations sans sacrifier la performance.
Pour une équipe technique, la leçon pratique est simple : testez l'impact de chaque règle d'anonymisation sur vos propres cas d'usage avant de la généraliser, et surveillez les publications qui affinent ces méthodes.
Ce que les équipes sous-estiment dans l'anonymisation des prompts
La plupart des articles sur l'anonymisation traitent le sujet comme un problème purement technique : trouver la bonne regex, entraîner le bon modèle NER. C'est une erreur de perspective. Le vrai défi n'est pas de détecter une donnée sensible, c'est de décider ce qu'on fait de la relation qu'elle porte avec le reste du prompt.
Une entreprise peut posséder le meilleur détecteur d'entités du marché et produire malgré tout des prompts anonymisés inutilisables, parce qu'elle a supprimé le lien entre un rôle et une décision, ou entre une date et un montant. Le compromis privacy-utility n'est pas un détail d'implémentation : c'est la question stratégique qui devrait précéder tout choix d'outil.
L'autre angle mort concerne la gouvernance. Beaucoup d'équipes techniques traitent l'anonymisation comme une case à cocher côté ingénierie, alors qu'elle engage directement la responsabilité juridique de l'entreprise en cas de demande d'accès ou de contrôle. Une pseudonymisation techniquement parfaite mais sans mapping documenté ni politique de rétention claire n'apporte qu'une protection partielle. Les deux dimensions, technique et documentaire, doivent avancer ensemble, sans quoi l'une finit toujours par trahir l'autre.
— Adopt
Une solution suisse pensée pour l'anonymisation dès la conception
Une solution souveraine d'espace de travail IA peut offrir une anonymisation automatique des prompts et des journaux d'audit intégrés nativement, sans configuration technique lourde côté client.
Contrairement à une pile d'outils assemblés maison, où chaque brique (détection, mapping, journalisation) doit être maintenue séparément, de telles fonctions peuvent être réunies dans une seule plateforme hébergée en Suisse, conforme à la nLPD. Les entreprises réglementées, du secteur juridique à la santé, peuvent y trouver un contrôle d'accès administrateur et une gestion de rôles conçus pour documenter chaque traitement sans effort supplémentaire.
Pour évaluer concrètement l'ensemble des fonctionnalités disponibles, consultez les fonctionnalités de Nectos et identifiez celles qui correspondent à votre flux de travail actuel.
Sources
Les sources mobilisées ici couvrent trois angles complémentaires : le cadre juridique suisse (ICTjournal sur la LPD et l'IA, Juriup sur les demandes d'accès), les méthodes techniques d'anonymisation validées par la recherche (arXiv sur l'optimisation privacy-utility), et les recommandations opérationnelles pour les équipes IA en entreprise (Orange ITS sur la conformité nLPD).
- Adaptive Text Anonymization: Learning Privacy-Utility Trade-offs via Prompt Optimization
- Agents IA et LPD révisée : la conformité nLPD en pratique | Orange ITS
- Demande accès LPD prompts IA : guide expert
Questions fréquentes
Que signifie anonymiser un prompt ?
Anonymiser un prompt consiste à remplacer ou masquer les identifiants personnels ou sensibles avant qu'il n'atteigne un modèle d'IA, tout en préservant les relations contextuelles nécessaires à une réponse pertinente.
Quelles sont les techniques d'anonymisation les plus utilisées en IA ?
Les regex pour les patterns structurés, la reconnaissance d'entités nommées pour le texte libre, et la pseudonymisation réversible via mapping chiffré forment le socle des techniques employées en pratique.
Pouvez-vous donner des exemples de données anonymisées dans un prompt ?
Un email remplacé par [CONTACT_1], un nom de client substitué par [CLIENT_A], ou une URL interne remplacée par un identifiant générique illustrent des substitutions courantes qui conservent la structure du texte.
Quels outils permettent d'anonymiser efficacement des prompts ?
Les bibliothèques combinant regex et NER, intégrées dans un pipeline CI/CD avec tests adversariaux, couvrent l'essentiel des besoins. Une plateforme comme Nectos propose cette anonymisation automatique directement intégrée, sans configuration technique séparée.
Faut-il toujours réaliser une DPIA avant d'anonymiser des prompts ?
Une analyse d'impact devient nécessaire dès que le traitement présente un risque élevé pour les personnes concernées, conformément aux exigences de la LPD révisée applicables aux traitements IA.