La pseudonymisation rend les données réidentifiables dès qu'on dispose de l'information supplémentaire adéquate, ce qui les maintient sous le régime des lois sur la protection des données. L'anonymisation, elle, vise l'irréversibilité pratique : si la réidentification devient impraticable avec des moyens raisonnables, les données sortent du champ d'application de la nLPD et du RGPD. Pour un professionnel suisse, la conséquence est directe : pseudonymiser ne dispense d'aucune obligation de conformité, alors qu'anonymiser correctement le fait, à condition de pouvoir le démontrer.
En bref:
- La pseudonymisation reste une donnée personnelle soumise au RGPD et à la nLPD, car elle peut être réidentifiée avec des moyens raisonnables.
- L'anonymisation véritable doit rendre la réidentification pratiquement impossible, en dépassant le simple chiffrement ou le masquage.
- La méthode d'évaluation du risque se concentre sur le coût, la disponibilité des données externes, la technologie et la fréquence d'accès.
- La combinaison de techniques comme la généralisation, l'agrégation et la randomisation renforce la sécurité contre le recoupement externe.
- En cas de doute, privilégier la pseudonymisation avec un contrôle rigoureux tout en documentant chaque étape d'évaluation du risque.
Table des matières
- Pseudonymisation vs anonymisation : les définitions qu'il faut maîtriser
- Ce que le RGPD et la nLPD suisse imposent réellement
- Les techniques concrètes de pseudonymisation et d'anonymisation
- Comment évaluer le risque de réidentification : la méthode en pratique
- Quand choisir la pseudonymisation, quand choisir l'anonymisation
- Intégrer ces techniques dans une architecture IA souveraine
- Ce qu'il faut retenir pour trancher rapidement
- Notre avis sur la confusion pseudonymisation/anonymisation
- Sources
- Questions fréquentes
Pseudonymisation vs anonymisation : les définitions qu'il faut maîtriser
Le terme anonymisation vs pseudonymisation recouvre deux réalités techniques et juridiques bien distinctes, souvent confondues dans les cahiers des charges. La pseudonymisation remplace un identifiant direct (nom, numéro de sécurité sociale, adresse e-mail) par un code ou un jeton, tout en conservant, séparément, la table de correspondance ou la clé permettant de revenir à l'identité d'origine. Un dossier patient où le nom devient « Patient_4521 » reste une donnée personnelle tant que la table de correspondance existe quelque part, même chiffrée.
L'anonymisation, elle, supprime ou transforme l'information au point qu'aucune clé, aucune table, aucun recoupement raisonnable ne permette de revenir en arrière. Selon LEXR, la qualification juridique dépend justement de cette identifiabilité résiduelle : si des moyens raisonnables permettent de réidentifier, le traitement reste une pseudonymisation des données ; si l'effort requis est disproportionné, on entre dans l'anonymisation.
Deux notions voisines méritent d'être distinguées :
- La dé-identification est un terme plus large, souvent utilisé aux États-Unis, qui recouvre à la fois pseudonymisation et anonymisation sans faire la distinction juridique européenne.
- La tokenisation est une technique de pseudonymisation qui remplace une donnée par un jeton généré aléatoirement, fréquemment utilisée dans les systèmes de paiement et les journaux applicatifs.
- Le masquage de données (data masking) altère l'affichage d'une donnée sans forcément casser le lien avec l'original, ce qui en fait rarement une véritable anonymisation.
Un log serveur qui remplace une adresse IP par un hachage reste pseudonymisé. Un jeu de données d'entraînement pour l'IA où les âges sont regroupés par tranches de dix ans et les localisations réduites à la région tend cependant vers l'anonymisation.
Ce que le RGPD et la nLPD suisse imposent réellement
La portée juridique de ces deux techniques n'est pas symétrique. Une donnée pseudonymisée reste une donnée personnelle au sens du RGPD comme de la nLPD : elle continue de déclencher les obligations de base légale, de durée de conservation, de sécurité et de notification en cas de violation. Une donnée réellement anonymisée sort du champ d'application de ces textes, selon les positions rappelées par les autorités suisses en matière de protection des données.
La loi fédérale sur la protection des données précise que les données doivent être rendues anonymes dès que la finalité du traitement le permet, ou que des mesures doivent garantir l'impossibilité pratique de les réidentifier. C'est un principe de minimisation, pas une option cosmétique.
À retenir : le critère central retenu par la jurisprudence et les autorités européennes n'est pas « est-ce techniquement possible de réidentifier », mais « avec quels moyens raisonnablement susceptibles d'être mobilisés, par qui, et à quel coût ». C'est le test du « motivated intruder » : on évalue le risque en imaginant un tiers motivé, disposant de ressources réalistes, cherchant activement à réidentifier un individu.
Concrètement, l'évaluation porte sur plusieurs critères :
- Le coût et le temps nécessaires à la réidentification.
- La disponibilité de jeux de données externes permettant un recoupement.
- L'état de la technologie disponible au moment du traitement, et son évolution prévisible.
- Le caractère isolé ou répété de l'accès aux données.
Une pseudonymisation mal documentée expose à des sanctions en cas de contrôle : la CNIL a par exemple rappelé à plusieurs reprises que la simple suppression du nom d'un individu, sans traitement des autres champs, ne suffit jamais à sortir du champ du RGPD. Le risque juridique n'est pas théorique. Il porte sur la responsabilité du responsable de traitement, sur la durée de conservation autorisée, et sur les conditions de transfert à des tiers.
Les techniques concrètes de pseudonymisation et d'anonymisation
Sur le terrain, quatre familles de techniques dominent la pseudonymisation des données :
- Le hachage avec sel (salt) ou poivre (pepper) transforme une valeur en une empreinte irréversible en apparence, mais reste vulnérable aux attaques par dictionnaire si le sel est mal géré.
- Le chiffrement avec gestion séparée des clés permet un retour en arrière contrôlé, à condition que la clé soit stockée indépendamment des données chiffrées.
- La tokenisation remplace une valeur par un jeton sans relation mathématique directe, souvent via une table de correspondance externe.
- Le mapping chiffré combine les deux logiques pour des systèmes distribués à grande échelle.
Le NIST documente précisément ces primitives cryptographiques, notamment les algorithmes de hachage à clé, qui restent des briques techniques standards dans ce domaine.
Pour l'anonymisation, les approches diffèrent radicalement : généralisation (remplacer un âge exact par une tranche), agrégation (regrouper des individus en catégories statistiques), randomisation (ajouter du bruit contrôlé), suppression pure et simple des champs sensibles, ou encore le k-anonymat, qui garantit que chaque enregistrement soit indiscernable d'au moins k-1 autres. La differential privacy, plus récente, introduit du bruit calibré mathématiquement pour garantir une protection même contre des attaques par recoupement répété.
Conseil de pro : ne misez jamais sur une seule technique. Le guide publié par la HEVS le rappelle : combiner généralisation, agrégation et randomisation est généralement nécessaire, car un mécanisme isolé laisse presque toujours filtrer des quasi-identifiants exploitables par recoupement.
La limite principale reste le recoupement externe. Un article publié dans Science souligne que l'anonymisation est un spectre mouvant : ce qui semblait suffisamment robuste il y a cinq ans peut devenir vulnérable avec l'augmentation de la puissance de calcul et la multiplication des jeux de données publics disponibles pour croiser les informations.
Comment évaluer le risque de réidentification : la méthode en pratique
Avant de qualifier un traitement d'anonymisation, une checklist structurée s'impose :
- Cartographier les accès : qui peut consulter la donnée transformée, et dans quel contexte ?
- Identifier les sources externes de recoupement : bases publiques, réseaux sociaux, open data sectoriel.
- Évaluer la granularité résiduelle : des champs comme le code postal à 4 chiffres croisé avec une date de naissance suffisent souvent à réidentifier un individu isolé.
- Mesurer la fréquence de publication ou d'accès : un jeu de données mis à jour quotidiennement expose davantage qu'un export ponctuel.
- Simuler une attaque contrôlée : faire réaliser un test de réidentification par un évaluateur externe, dans une logique de « motivated intruder ».
- Documenter chaque étape : conserver les rapports de test, les décisions prises et les mesures correctives comme preuve de diligence en cas de contrôle.
Si le risque ressort trop élevé après ce test, plusieurs mesures correctives restent disponibles : séparation renforcée des clés de correspondance, restriction d'accès par rôle, ou masquage additionnel sur les champs les plus discriminants. La documentation de cette démarche n'est pas un exercice bureaucratique : elle constitue la preuve concrète que l'entreprise a raisonnablement évalué le risque, un point que les autorités de contrôle examinent en priorité lors d'un audit.
Quand choisir la pseudonymisation, quand choisir l'anonymisation
Le choix dépend presque toujours de la finalité métier. Pour l'entraînement de modèles d'intelligence artificielle ou le partage de données à des chercheurs externes, l'anonymisation reste préférable dès qu'elle est atteignable, car elle allège la charge de conformité et facilite le partage. Pour un usage interne nécessitant un retour à l'identité (support client, audit RH, suivi médical longitudinal), la pseudonymisation s'impose puisque la réversibilité est fonctionnellement requise.
Quelques repères sectoriels :
- Santé : la pseudonymisation domine pour le suivi clinique ; l'anonymisation intervient pour la recherche statistique agrégée.
- Ressources humaines : les données de paie restent pseudonymisées, les statistiques de diversité peuvent être anonymisées.
- Analytique web et IA : anonymiser les prompts avant leur envoi à un moteur d'analyse réduit fortement l'exposition, notamment quand le volume de données traitées est important.
Les critères de décision tiennent en trois axes : l'utilité restante des données après transformation, le niveau de risque acceptable au vu de la sensibilité, et le coût opérationnel de chaque approche.
Intégrer ces techniques dans une architecture IA souveraine
Pour les professionnels suisses qui utilisent l'intelligence artificielle au quotidien, la question d'anonymiser des invites IA n'est plus théorique. Une architecture bien conçue applique plusieurs mesures simultanément :
- Anonymisation automatique des invites avant tout traitement par le modèle, afin de limiter l'exposition dès la saisie.
- Séparation stricte entre les données transformées et les clés ou tables de correspondance, avec contrôle d'accès par rôle.
- Journaux d'audit exportables, permettant de documenter chaque décision de traitement en cas de contrôle.
L'hébergement exclusivement sur des serveurs suisses réduit mécaniquement le risque de transfert transfrontalier incontrôlé, un point sensible sous la nLPD. Ce principe de souveraineté des données doit être appliqué comme garantie structurelle, et non présenté comme un argument commercial : les données ne doivent jamais transiter vers des infrastructures soumises à des juridictions extraterritoriales.
Ce qu'il faut retenir pour trancher rapidement
Pseudonymisez quand la réversibilité est fonctionnellement nécessaire ; anonymisez dès que c'est atteignable et documentable. En cas de doute persistant, retenez la pseudonymisation, accompagnée de contrôles d'accès stricts et d'une évaluation écrite du risque. La prochaine étape concrète : cartographier vos flux de données, auditer les moyens de réidentification disponibles, puis mettre en œuvre les mesures techniques adaptées.
Notre avis sur la confusion pseudonymisation/anonymisation
La plupart des entreprises suisses traitent la pseudonymisation comme une case à cocher, alors qu'elle ne change rien à leurs obligations légales. C'est là l'erreur la plus coûteuse qu'on observe dans ce domaine : croire qu'un simple hachage ou un jeton suffit à sortir du champ de la nLPD. Ce n'est jamais le cas, et la documentation de l'évaluation du risque compte souvent plus que la technique elle-même en cas de contrôle.
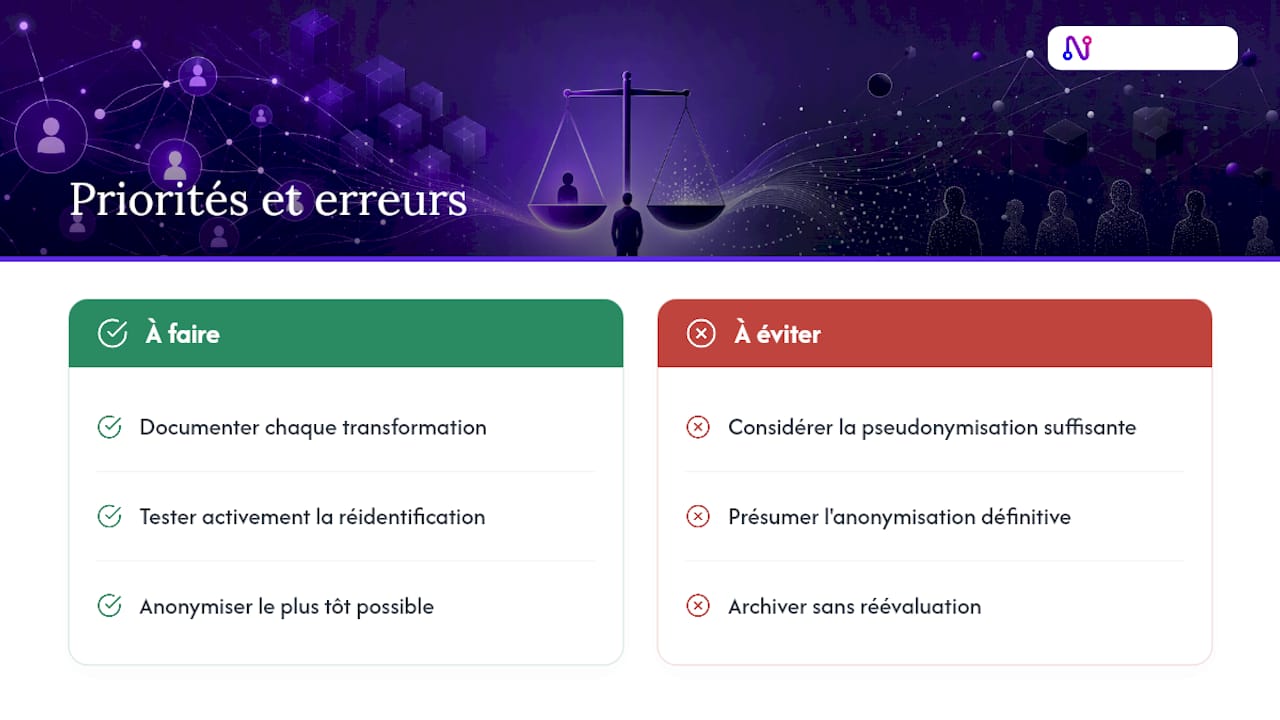
L'anonymisation, à l'inverse, est trop souvent survendue comme un état binaire et définitif. Ce n'est pas ainsi qu'elle fonctionne : c'est un spectre qui se dégrade avec le temps, à mesure que la puissance de calcul augmente et que de nouveaux jeux de données publics apparaissent. Un jeu de données anonymisé en 2022 mérite d'être réévalué en 2026, pas archivé comme définitivement conforme.
Ce que les équipes techniques et juridiques devraient prioriser : documenter chaque décision de transformation, tester activement la réidentification plutôt que de la supposer impossible, et choisir des architectures où l'anonymisation intervient le plus tôt possible dans le flux, avant même que la donnée sensible n'atteigne un système tiers.
— Adopt
Sources
Consultez la LPD suisse (RS 235.1), le guide d'anonymisation de la HEVS et le glossaire du NIST.
Pour une mise en œuvre pratique, la page sécurité de Nectos détaille les mesures techniques et organisationnelles applicables, et l'agence Lucioles accompagne l'intégration d'automatisations IA respectant ces principes.
Vous cherchez un espace de travail IA qui applique ces principes par conception plutôt qu'en option ? Nectos héberge exclusivement vos données sur des serveurs suisses, anonymise automatiquement vos invites et fournit des journaux d'audit exportables pour vos obligations de conformité nLPD.
- RS 235.1 - Loi fédérale sur la protection des données (LPD)
- NIST Computer Security Resource Center — keyed hash algorithm
Questions fréquentes
Quelle est la différence entre pseudonymisation et anonymisation ?
La pseudonymisation reste réversible grâce à une information supplémentaire conservée séparément, ce qui maintient la donnée sous le régime du RGPD et de la nLPD. L'anonymisation vise une irréversibilité pratique qui, si elle est démontrée, fait sortir la donnée du champ de ces lois.
Quelles sont les techniques de pseudonymisation les plus courantes ?
Le hachage avec sel, le chiffrement avec gestion séparée des clés, la tokenisation et le mapping chiffré constituent les quatre approches principales, chacune documentée par des standards comme ceux du NIST.
Quelle est la différence entre tokenisation et pseudonymisation ?
La tokenisation est une méthode spécifique de pseudonymisation : elle remplace une valeur par un jeton généré aléatoirement, sans relation mathématique directe, via une table de correspondance externe.
Quelle est la différence entre pseudonymisation et dé-identification ?
La dé-identification est un terme plus large qui englobe pseudonymisation et anonymisation sans distinction juridique stricte, alors que le RGPD et la nLPD séparent nettement les deux régimes selon le critère de réidentifiabilité.