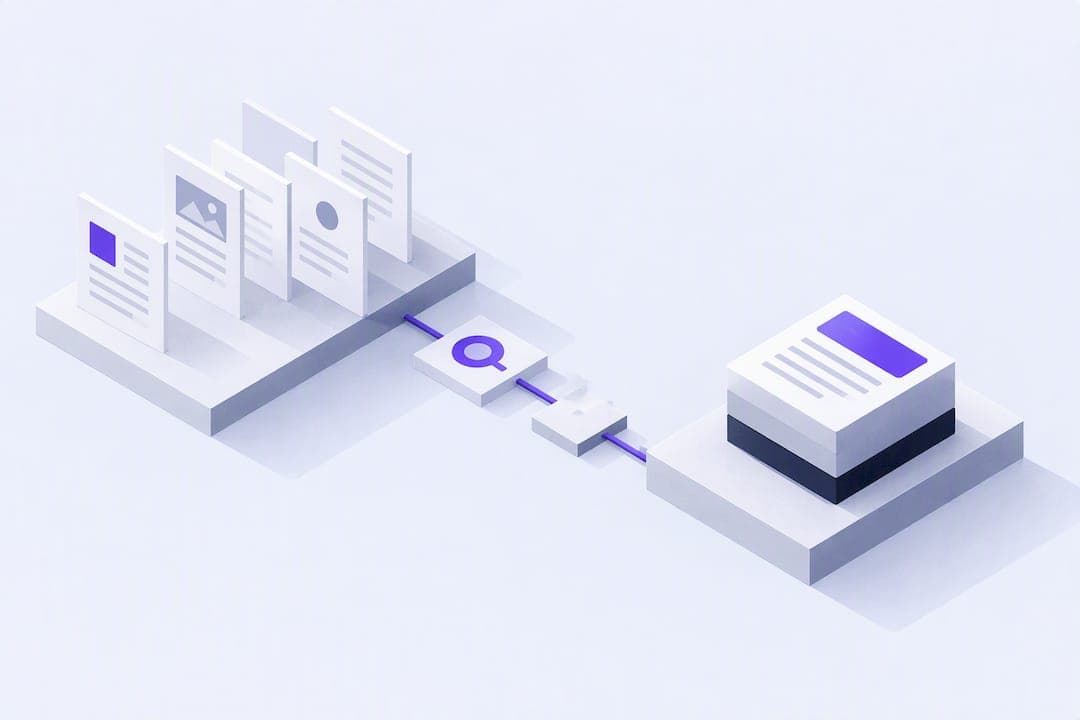
RAG (Retrieval-Augmented Generation) kombiniert gezielten Informationsabruf mit einem Sprachmodell, sodass Antworten faktengenauer und aktueller werden. Statt sich nur auf trainiertes Wissen zu verlassen, durchsucht ein RAG-System externe Quellen in Echtzeit und reichert die Antwort des Sprachmodells mit diesen Fakten an. Wie das technisch abläuft, wo die Grenzen liegen und welche Bausteine eine Architektur braucht, zeigen wir im Folgenden.
Kurz gesagt:
- RAG-Systeme greifen in Echtzeit auf externe Quellen zu, filtern relevante Textausschnitte und kombinieren diese mit Nutzeranfragen, um aktuelle und faktentreue Antworten zu liefern.
- Die zuverlässige Funktion hängt stark von der Datenqualität ab, wobei schlechte Quellen und widersprüchliche Dokumente zu ungenauen Antworten führen können.
- Für sensible Daten sollten Zugriffsrechte sorgfältig geregelt sein, da unkontrollierte Datenverarbeitung Datenschutz- und Compliance-Risiken birgt.
- Die technische Architektur basiert auf Komponenten wie Vektor-Embeddings, Suchspeichern und Ranking-Algorithmen, um relevante Dokumente effizient zu ermitteln.
- Vor der Einführung empfiehlt sich eine gründliche Daten- und Qualitätsprüfung sowie das Festlegen von Metriken zur kontinuierlichen Kontrolle der Antwortqualität.
Inhaltsverzeichnis
- Wie RAG funktioniert: Retrieval, Augmentation und Generation
- Warum RAG gegenüber reinem LLM-Output überzeugt
- Einsatzbereiche: Wo RAG in der Praxis zum Einsatz kommt
- Grenzen und Risiken: Wann RAG an seine Grenzen stößt
- Technische Bausteine einer RAG-Architektur
- Checkliste vor der RAG-Einführung
- Souveräne RAG-Grundlage für Schweizer Teams
- FAQ
Wie RAG funktioniert: Retrieval, Augmentation und Generation
RAG läuft in einer festen Abfolge von Schritten ab, die Suche und Texterzeugung miteinander verzahnt.
- Anfrageanalyse und Vektorisierung: Die Nutzeranfrage wird in einen Vektor umgewandelt, der ihre Bedeutung numerisch abbildet.
- Suche im Vektorstore: Ein Retriever vergleicht diesen Vektor mit gespeicherten Dokumentvektoren und findet die passendsten Treffer.
- Auswahl und Aufbereitung des Kontexts: Die relevantesten Textausschnitte werden gefiltert, gekürzt und in eine verwertbare Form gebracht.
- Prompt-Injektion und Generierung: Das Sprachmodell erhält die Nutzerfrage zusammen mit den gefundenen Textstellen und formuliert daraus die Antwort.
Ein kleines Beispiel macht das greifbar: Eine Mitarbeiterin fragt „Wie lange ist unsere Kündigungsfrist für Lieferantenverträge?“. Das System durchsucht die interne Vertragsdatenbank, findet die passende Klausel aus einem gespeicherten Vertragsdokument und übergibt diesen Abschnitt an das Sprachmodell. Die Antwort zitiert die konkrete Frist, nicht eine generische Vermutung.
Dabei spielen mehrere Komponenten zusammen:
- Ein Embedding-Modell wandelt Text in Vektoren um.
- Ein Vektorstore speichert und durchsucht diese Vektoren effizient.
- Ein Retriever entscheidet, welche Dokumente als Kontext dienen.
- Das Sprachmodell generiert aus Frage und Kontext die endgültige Antwort.
Diese Kette unterscheidet RAG fundamental von einem reinen Sprachmodell, das nur auf sein Trainingswissen zugreift.
Warum RAG gegenüber reinem LLM-Output überzeugt
Ein Sprachmodell ohne Retrieval kennt nur das, was zum Trainingszeitpunkt vorlag. RAG schließt diese Lücke, indem es externe, aktuelle Datenquellen in jede Antwort einbezieht.
- Antworten bleiben aktuell, weil die Datenquelle unabhängig vom Modell aktualisiert werden kann.
- Firmenspezifisches Wissen lässt sich einbinden, ohne das Modell neu zu trainieren.
- Antworten werden nachvollziehbarer, wenn das System die Quelle mit ausgibt.
- Große Dokumentbestände lassen sich durchsuchen, ohne sie in den Prompt zu quetschen.
Profi-Tipp: Lassen Sie das System bei jeder Antwort die Quelle mit angeben, so prüfen Nutzer die Aussage in Sekunden nach.
Gerade für Teams, die mit internen Handbüchern, Richtlinien oder Vertragswerken arbeiten, macht dieser Unterschied den praktischen Wert aus: Das Wissen wächst mit den Dokumenten, nicht mit einem neuen Trainingslauf.

Einsatzbereiche: Wo RAG in der Praxis zum Einsatz kommt
RAG eignet sich überall dort, wo Antworten auf einem begrenzten, aber veränderlichen Wissensbestand beruhen sollen.
- Interne Wissensdatenbanken und Onboarding: Neue Mitarbeitende stellen Fragen zu Prozessen, das System antwortet mit Verweis auf das passende interne Dokument.
- Kundenservice-Bots mit firmenspezifischem Wissen: Anfragen zu Produkten oder Verträgen werden direkt aus aktuellen Unterlagen beantwortet, statt generische Floskeln zu liefern.
- Vertrags- und Dokumentenanalyse: Juristische Teams lassen sich relevante Klauseln aus umfangreichen Vertragswerken heraussuchen.
- Rechercheassistenten: Fachleute durchsuchen große Textsammlungen, ohne jedes Dokument einzeln zu öffnen.
Ein Beispiel aus der Praxis: Eine Analystin fragt einen Rechercheassistenten nach dem Umsatzwachstum im letzten Jahresbericht. Das System findet den relevanten Absatz, zitiert die Zahl direkt aus dem Dokument und verweist auf die Seite. Nectos bietet mit privaten Wissensdatenbanken und Dokumentenanalyse eine Grundlage für solche Anwendungen, bei der interne Unterlagen durchsuchbar werden, ohne die Schweiz zu verlassen.
Grenzen und Risiken: Wann RAG an seine Grenzen stößt
RAG löst nicht jedes Problem automatisch, und die Qualität der Antwort hängt direkt von der Qualität der zugrunde liegenden Daten ab.
- Schlechte oder widersprüchliche Quellendokumente führen zu unzuverlässigen Antworten, RAG repariert keine mangelhafte Datenqualität.
- Halluzinationen können trotz Retrieval auftreten, etwa wenn das Modell über den gefundenen Kontext hinaus Annahmen trifft.
- Sensible Dokumente bergen Datenschutz- und Compliance-Risiken, wenn Zugriffsrechte nicht sauber abgebildet sind.
- Ohne laufende Evaluation und Feedbackschleifen bleiben systematische Fehler unentdeckt.
Üblicherweise werden Präzision, Recall und MRR als Kernmetriken zur Bewertung der Antwortqualität herangezogen, ergänzt durch menschliche Prüfrunden, die Halluzinationen aufdecken. Wer mit vertraulichen Verträgen oder Personaldaten arbeitet, sollte Zugriffssteuerung und Datenresidenz von Anfang an mitdenken, nicht erst nach dem ersten Vorfall.
Technische Bausteine einer RAG-Architektur
Jede RAG-Lösung steht auf denselben Grundpfeilern, auch wenn die konkrete Umsetzung stark variiert.
- Embeddings: Das gewählte Embedding-Modell bestimmt, wie gut semantische Nähe erkannt wird.
- Vektorstore: Persistenz, Latenz und Skalierbarkeit entscheiden, ob das System auch bei wachsendem Dokumentbestand performant bleibt.
- Retriever-Strategie: Dense Retrieval arbeitet mit semantischen Vektoren, sparse Retrieval mit klassischen Suchbegriffen, Hybrid-Ansätze kombinieren beides.
- Ranking und Passage-Selection: Nicht jeder Treffer ist gleich relevant, ein Ranking-Schritt sortiert die besten Ausschnitte nach oben.
- Prompt-Design: Wie der Kontext in den Prompt eingefügt wird, beeinflusst direkt, wie gut das Modell ihn nutzt.
Die folgende Übersicht ordnet die wichtigsten Komponenten und ihre Hauptfunktion ein:
| Komponente | Hauptfunktion |
|---|---|
| Embedding-Modell | Wandelt Text in semantische Vektoren um |
| Vektorstore | Speichert und durchsucht Vektoren effizient |
| Retriever | Wählt relevante Dokumente oder Passagen aus |
| Ranker | Sortiert gefundene Treffer nach Relevanz |
| Prompt-Injektion | Fügt Kontext strukturiert in die Modellanfrage ein |
Retriever-Fehler und schlechte Passage-Selektion zählen zu den häufigsten Ursachen für systematisch falsche Antworten, Ensemble- oder Fusion-Strategien können hier Abhilfe schaffen. Bei langen Dokumenten kommt hinzu, dass Kontexte sinnvoll geschnitten werden müssen, sonst geht Relevanz verloren, bevor das Modell überhaupt antwortet.
Checkliste vor der RAG-Einführung
Bevor ein Team RAG produktiv einsetzt, lohnt sich ein nüchterner Blick auf vier Punkte: Ist die Datenbasis bereinigt und konsistent? Sind Zugriffsrechte pro Dokument sauber definiert? Existiert ein Testkorpus mit echten Beispielfragen? Und gibt es Metriken, mit denen sich Antwortqualität laufend prüfen lässt?

RAG schlägt Fine-Tuning immer dann, wenn sich Wissen häufig ändert oder aus vielen einzelnen Dokumenten stammt, Fine-Tuning lohnt sich eher bei stabilem, stilistisch geprägtem Verhalten. Die Entscheidung hängt also weniger von der Technik ab als von der Änderungsfrequenz der Daten.
Governance bleibt dabei kein Nebenschauplatz: Logging, Audit-Trails und eine menschliche Kontrollinstanz für kritische Antworten verhindern, dass ein einzelner Fehler unbemerkt bleibt.
— Adopt
Souveräne RAG-Grundlage für Schweizer Teams
Wer RAG mit internen Dokumenten umsetzen will, steht vor einer zusätzlichen Frage: Wohin fließen die Daten während Retrieval und Generierung? Mit Nectos bleiben sämtliche Daten ausschließlich in der Schweiz, verarbeitet auf Schweizer Servern gemäß nLPD, ohne dass Inhalte an ausländische Anbieter wie OpenAI, Google oder Microsoft zur Modell-Trainierung weitergegeben werden. Unsere Wissensdatenbanken und Dokumentenanalyse bilden genau die Grundlage, die ein internes RAG-System braucht: durchsuchbare, firmenspezifische Unterlagen mit nachvollziehbarer Herkunft.
Unsere Datenflüsse legen offen, wie Dokumente verarbeitet werden, und das Sicherheits- und Compliance-Paket unterstützt Teams, die zusätzliche Nachweise für Audits benötigen. Für Unternehmen mit eigenen Hosting-Anforderungen bieten wir zudem eine BYOC- oder On-Premise-Bereitstellung an.
Der Einstieg beginnt mit dem Starter-Plan ab 29.90 CHF pro Platz und Monat, der private KI-Chats und Wissensdatenbanken bereits enthält. Wer die Lösung zunächst unverbindlich testen möchte, kann über denselben Pricing-Bereich eine Testphase anfragen, bevor ein größeres Team umsteigt.
FAQ
Was ist ein RAG einfach erklärt?
RAG steht für ein System, das vor der Antwortgenerierung passende Dokumente sucht und diese dem Sprachmodell als Kontext mitgibt. Dadurch stützt sich die Antwort auf konkrete, nachprüfbare Quellen statt nur auf trainiertes Wissen.
Ist ChatGPT ein RAG?
ChatGPT ist in seiner Grundform ein Sprachmodell ohne festen Retrieval-Mechanismus über externe, firmeneigene Dokumente. Bestimmte Erweiterungen können Websuche oder Dateianalyse hinzufügen, das ändert aber nichts daran, dass RAG als Architekturprinzip und ChatGPT als Produkt zwei unterschiedliche Dinge sind.
Was ist der Unterschied zwischen LLM und RAG?
Ein LLM ist das Sprachmodell selbst, das Text auf Basis seines Trainings generiert. RAG ist eine Architektur, die ein LLM mit einem Retrieval-Schritt kombiniert, sodass die Antwort zusätzlich auf extern abgerufenen Dokumenten beruht.
Für was steht die Abkürzung RAG?
RAG steht für Retrieval-Augmented Generation, also die Erweiterung der Textgenerierung um einen vorgeschalteten Informationsabruf. Der Begriff beschreibt damit sowohl die Technik als auch die Architektur, nicht ein einzelnes Produkt.
Wann lohnt sich RAG gegenüber Fine-Tuning?
RAG eignet sich besonders, wenn sich Wissen häufig ändert oder aus vielen einzelnen Dokumenten stammt, etwa bei internen Richtlinien oder Verträgen. Fine-Tuning lohnt sich eher, wenn stabiles, stilistisches Verhalten des Modells im Vordergrund steht statt wechselndes Faktenwissen.