Le RAG (retrieval augmented generation) est l'architecture qui connecte un modèle de langage à des documents externes avant qu'il ne rédige sa réponse, au lieu de le laisser piocher uniquement dans ses paramètres figés. Le bénéfice est direct : des réponses vérifiables, actualisées et traçables jusqu'à leur source, là où un modèle seul invente parfois des faits avec assurance. Les benchmarks publics montrent que les patterns avancés font passer le taux d'erreur de retrieval d'un faible pourcentage à 1,9 % en configuration production.
En bref:
- Le RAG permet d'obtenir des réponses vérifiables, actualisées et traçables en reliant le modèle de langage à des documents externes, avec un taux d'erreur de retrieval réduit à 1,9 %.
- La différence essentielle avec le fine-tuning réside dans le fait que le RAG ne modifie pas les poids du modèle, mais enrichit le contexte de la requête avec des extraits pertinents en temps réel.
- La fiabilité du pipeline RAG repose sur des techniques avancées telles que le retrieval hybride, le reranking neuronal et la recherche contextuelle, qui réduisent significativement le bruit et les erreurs.
- La souveraineté des données impose de privilégier un hébergement local en Suisse et d'anonymiser les prompts pour protéger les documents sensibles.
- Construire un RAG robuste en 2026 nécessite une industrialisation progressive, des tests réguliers sur des métriques comme le Recall@k et une montée en charge mesurée pour respecter la conformité et la performance.
Table des matières
- Qu'est-ce que le RAG expliqué simplement, et en quoi diffère-t-il du fine-tuning ?
- Comment fonctionne le RAG, étape par étape ?
- Quels bénéfices concrets le RAG apporte-t-il en entreprise ?
- Quels composants techniques choisir pour construire un RAG fiable ?
- Comment fiabiliser le retrieval en production ?
- Quelles métriques mesurent vraiment la qualité d'un RAG ?
- Comment déployer un RAG en respectant la souveraineté des données ?
- Perspective : quelles priorités pour les équipes IA en 2026 ?
- Nectos : une alternative souveraine pour construire votre RAG en Suisse
- Sources
- Questions fréquentes
Qu'est-ce que le RAG expliqué simplement, et en quoi diffère-t-il du fine-tuning ?
Le RAG répond à un problème précis : un LLM entraîné une fois pour toutes ne connaît ni vos documents internes, ni l'actualité postérieure à son entraînement. Il enrichit le contexte transmis au modèle avec des extraits pertinents issus d'une base de connaissances externe pour produire des réponses ancrées dans des sources réelles, consultables et datées.
La confusion la plus fréquente chez les étudiants en IA porte sur la distinction avec le fine-tuning. Le fine-tuning réentraîne les poids du modèle sur un corpus spécifique : coûteux, lent à mettre à jour, mais utile pour changer un style ou un comportement. Le RAG, lui, ne touche pas au modèle : il change ce qu'on lui donne à lire au moment de la requête.
- Recherche documentaire classique : renvoie une liste de documents, à charge pour l'utilisateur de les lire et synthétiser.
- Fine-tuning : modifie durablement le modèle, mais fige la connaissance à la date d'entraînement.
- RAG : combine recherche et génération, produit une réponse rédigée et sourcée, actualisable en temps réel.
Un exemple concret : un assistant juridique interrogé sur un arrêt récent. Sans RAG, le modèle répond avec ce qu'il a appris il y a des mois, parfois de façon inventée. Avec RAG, il va chercher le texte de l'arrêt dans une base documentaire, puis rédige sa réponse à partir de ce texte précis.
Comment fonctionne le RAG, étape par étape ?
Le pipeline RAG se découpe en cinq étapes techniques, chacune avec ses propres arbitrages. Comprendre chaque maillon évite les erreurs de conception qui plombent silencieusement la qualité finale.
- Ingestion et chunking : les documents sont découpés en fragments (chunks) de 200 à 800 tokens généralement, avec un chevauchement de 10 à 20 % pour ne pas couper une idée en plein milieu. Chaque chunk garde des métadonnées : titre, date, auteur, section, ce qui permettra plus tard de filtrer ou de citer la source exacte.
- Embeddings : chaque chunk est transformé en vecteur numérique par un modèle d'embedding. Le point technique souvent négligé : la requête utilisateur doit être vectorisée avec le même modèle que les documents, sous peine d'incohérence géométrique entre les deux espaces vectoriels.
- Indexation : les vecteurs sont stockés dans une base vectorielle qui associe à chaque embedding ses métadonnées, pour permettre un filtrage combiné (similarité + critères structurés).
- Retrieval : à la requête, le système cherche les k chunks les plus proches sémantiquement, souvent en fusionnant plusieurs listes de résultats (recherche dense et recherche par mots-clés) pour couvrir à la fois le sens et les termes exacts.
- Augmentation et génération : les chunks retenus sont insérés dans le prompt envoyé au LLM, qui rédige alors sa réponse en s'appuyant sur ce contexte fourni plutôt que sur sa seule mémoire paramétrique.
Des tutoriels pratiques montrent qu'on peut assembler un prototype fonctionnel avec LangChain, une base vectorielle et un LLM en quelques heures. Le prototype valide le concept ; l'industrialisation, elle, se joue sur les patterns avancés détaillés plus bas.
Quels bénéfices concrets le RAG apporte-t-il en entreprise ?
Les gains les plus souvent documentés touchent trois axes : l'accès à des données à jour, la réduction des hallucinations et une meilleure traçabilité des réponses, puisque chaque affirmation peut être reliée à un document source.
Les cas d'usage se multiplient dans les organisations qui manipulent beaucoup de documents internes :
- Support client : l'assistant répond avec les procédures internes exactes, pas des généralités glanées lors de l'entraînement.
- Assistants internes : recherche dans les politiques RH, contrats types, notes de service, sans dépendre de la mémoire d'un collaborateur.
- Recherche juridique et conformité : citation des textes réglementaires exacts en vigueur, avec la référence précise.
- Extraction de connaissances : synthèse de rapports longs ou de bases documentaires techniques éparpillées.
L'impact réel se mesure moins en pourcentage de productivité qu'en réduction du temps passé à vérifier une réponse. Un juriste qui reçoit une citation exacte n'a plus besoin de rouvrir cinq documents pour la confirmer.
Quels composants techniques choisir pour construire un RAG fiable ?
Chaque couche de l'architecture RAG implique un arbitrage entre coût, précision et latence. Le choix du modèle d'embedding conditionne tout le reste : privilégiez un modèle multilingue si vos documents mêlent français, allemand et anglais, en gardant un œil sur la dimension du vecteur, qui influe directement sur le coût de stockage et la vitesse de recherche.
Les bases vectorielles doivent être évaluées sur plusieurs critères concrets :
- Localisation des données : région d'hébergement, ce qui compte particulièrement pour toute organisation soumise à la nLPD suisse.
- Scalabilité : capacité à gérer des millions de vecteurs sans dégradation du temps de réponse.
- Sécurité : chiffrement au repos et en transit, gestion fine des accès par rôle.
- API et intégrations : compatibilité avec les frameworks d'orchestration courants.
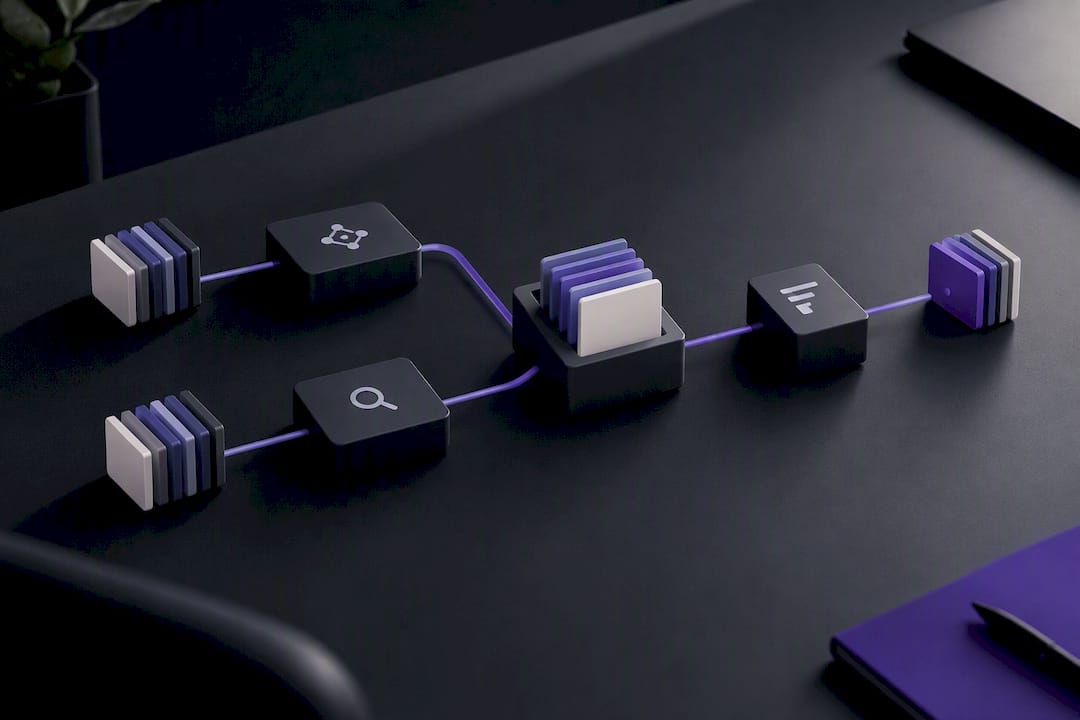
Sur le retrieval lui-même, deux familles coexistent. Le retrieval sparse (BM25) excelle sur les termes exacts, codes de référence ou numéros de dossier. Le retrieval dense, basé sur les embeddings, capte le sens même quand le vocabulaire diffère. Un reranker, souvent un cross-encoder, intervient ensuite pour retrier les meilleurs candidats et ne garder que les plus pertinents avant de les transmettre au modèle. Le compromis latence contre précision est réel : chaque étage supplémentaire ajoute quelques centaines de millisecondes, mais réduit sensiblement le bruit dans la réponse finale.
Comment fiabiliser le retrieval en production ?
Un RAG naïf, qui se contente d'une recherche vectorielle simple, produit encore trop d'erreurs pour des usages sensibles. Les patterns avancés changent la donne en s'attaquant directement aux points faibles du pipeline de base.
- Contextual Retrieval : ajouter un résumé contextuel à chaque chunk avant de le vectoriser, pour qu'il garde du sens même isolé de son document d'origine.
- Hybrid Search : fusionner les résultats vectoriels et BM25 via une méthode de fusion de rangs (RRF), ce qui réduit le bruit provenant des deux méthodes prises isolément.
- Reranking neuronal : un cross-encoder retrie les meilleurs candidats pour ne garder que les cinq réponses les plus pertinentes parmi les vingt initialement récupérées.
- Multi-query et HyDE : générer plusieurs reformulations de la requête, ou une réponse hypothétique servant de pivot de recherche, pour couvrir des angles que la question initiale ne capte pas.
Ces techniques combinées expliquent en grande partie l'écart entre un faible pourcentage et 1,9 % d'erreur observé sur des benchmarks de production. Les architectures les plus robustes intègrent aussi des boucles de vérification, où le système réinterroge la base si la première réponse semble insuffisamment étayée.
Conseil de pro : Ne déployez pas les quatre patterns d'un coup. Commencez par le Hybrid Search, souvent le gain le plus rapide à obtenir, puis ajoutez un reranker une fois que vous avez mesuré l'effet du premier changement.
Quelles métriques mesurent vraiment la qualité d'un RAG ?
Trois métriques structurent l'évaluation d'un pipeline RAG. Le Recall@k mesure la proportion de documents pertinents effectivement retrouvés parmi les k premiers résultats. Le MRR (mean reciprocal rank) évalue à quel rang apparaît le premier résultat pertinent, ce qui pénalise fortement un bon document mal classé. La faithfulness vérifie que la réponse générée reste fidèle aux documents récupérés, sans extrapolation du modèle.
- Testez sur un jeu d'évaluation représentatif de vos vraies requêtes, pas sur des questions académiques génériques.
- Ajoutez des cas adversariaux : questions pièges, formulations ambiguës, requêtes hors périmètre documentaire.
- Gardez une validation humaine sur un échantillon, même minime, pour calibrer vos seuils automatiques.
Un RAG naïf affiche généralement un taux d'erreur de retrieval d'un faible pourcentage, contre 1,9 % pour une architecture intégrant les patterns avancés cités plus haut.
Comment déployer un RAG en respectant la souveraineté des données ?
L'hébergement conditionne directement votre exposition légale. Un déploiement cloud hors de Suisse, chez un fournisseur soumis à une législation étrangère, peut exposer vos embeddings et vos documents source à des demandes d'accès extraterritoriales, alors même que ces vecteurs peuvent être requalifiés en données personnelles selon le contenu qu'ils encodent.
- Privilégiez un hébergement en Suisse pour tout document contenant des données clients, RH ou de santé.
- Anonymisez les prompts avant qu'ils ne quittent votre périmètre de confiance, quand une étape externe est incontournable.
- Mettez en place un contrôle d'accès par rôle et conservez des journaux d'audit exportables pour répondre à une obligation de conformité.
- Documentez la circulation de vos données entre ingestion, indexation et génération, pour pouvoir la justifier en cas de contrôle.
Perspective : quelles priorités pour les équipes IA en 2026 ?
La tentation actuelle est de sauter directement au RAG le plus sophistiqué possible. C'est une erreur d'ingénierie. Mieux vaut industrialiser progressivement : un pilote sur un périmètre documentaire restreint, des métriques de Recall@k et de faithfulness dès le premier jour, puis une montée en charge mesurée.
La souveraineté n'est plus un supplément de conformité, c'est un critère de sélection technique à part entière. Les équipes qui gagnent du temps sont celles qui testent leurs patterns avancés, Hybrid Search en tête, sur un sous-ensemble critique de documents avant de généraliser.
— Adopt
Nectos : une alternative souveraine pour construire votre RAG en Suisse
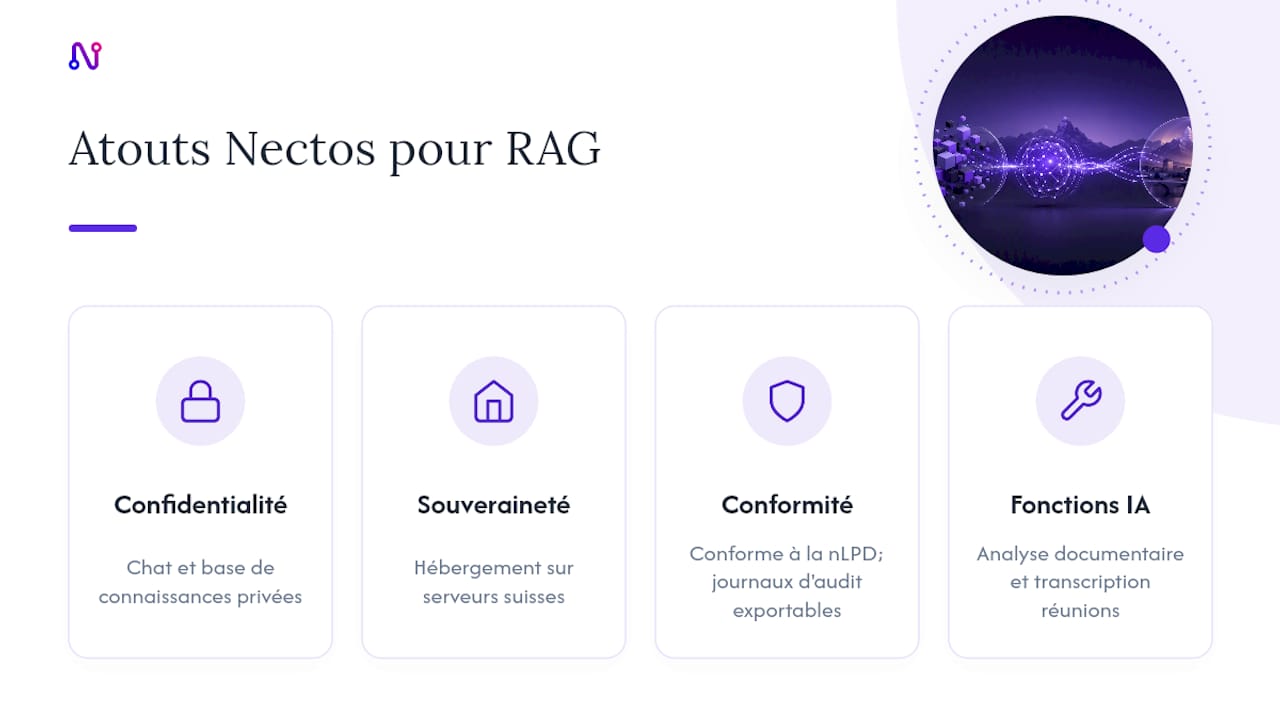
Construire un RAG suppose de faire transiter vos documents les plus sensibles par des couches d'embeddings, d'indexation et de génération. Nectos a conçu son espace de travail IA pour que cette chaîne reste entièrement suisse : chat IA privé, base de connaissances privée, analyse documentaire intelligente et transcription de réunions, le tout hébergé exclusivement sur des serveurs suisses, conforme à la nLPD.
Aucune donnée n'est partagée avec des géants technologiques étrangers, aucun entraînement n'est réalisé sur vos documents, et chaque accès laisse une trace dans des journaux d'audit exportables. Pour une entreprise réglementée (juridique, santé, finance, secteur public), c'est la différence entre externaliser un risque et garder un contrôle vérifiable sur ses vecteurs et ses documents sources. Les garanties techniques et de conformité sont détaillées sur la page sécurité de Nectos.
Nectos propose plusieurs formules par utilisateur et une version d'essai disponible. Consultez le détail des offres et tarifs pour choisir la formule adaptée à la taille de votre équipe.
Sources
Pour approfondir chaque brique du RAG, quelques ressources se distinguent par leur rigueur technique.
- What is RAG? - Retrieval-Augmented Generation AI ...
- What is RAG (Retrieval Augmented Generation)?
- RAG (Retrieval Augmented Generation) expliqué : architecture, patterns et étapes | Proactive Academy
- RAG Explained Simply with a Real Project
- Retrieval-Augmented Generation (RAG)
Questions fréquentes
Quelle taille de chunk choisir pour un RAG ?
La plupart des pipelines fonctionnent bien avec des chunks de 200 à 800 tokens et un chevauchement de 10 à 20 %. La taille optimale dépend surtout de la structure de vos documents : des contrats juridiques denses tolèrent des chunks plus longs qu'une base de FAQ courtes.
Qu'est-ce que le hybrid search et pourquoi l'utiliser ?
Le hybrid search combine une recherche vectorielle dense avec une recherche par mots-clés (BM25), puis fusionne les deux classements. Cette combinaison compense les faiblesses des embeddings sur les données exactes comme les codes de référence ou les numéros de dossier.
Les embeddings posent-ils un risque pour la confidentialité ?
Oui, un embedding peut dans certains cas être requalifié en donnée personnelle selon la nature du texte qu'il encode, ce qui implique de traiter son hébergement avec la même rigueur que le document source, en particulier sous contraintes de souveraineté suisses.
Combien coûte une solution RAG souveraine comme Nectos ?
Nectos propose plusieurs formules tarifaires par utilisateur et par mois, détaillées sur la page tarifs. Une version d'essai est également disponible pour tester la plateforme avant de s'engager.
Le RAG remplace-t-il complètement le fine-tuning ?
Non, les deux répondent à des besoins différents et se combinent parfois. Le RAG apporte une connaissance externe actualisable, tandis que le fine-tuning modifie durablement le comportement ou le style du modèle.